Одна модель, три провайдера: DeepSeek V4.1 Flash у DeepSeek, Ollama Cloud и OpenCode Go
В этой статье
Открытую модель сегодня продаёт кто угодно. DeepSeek V4.1 Flash можно взять у самого DeepSeek с оплатой за токены, у Ollama Cloud по такой же цене, по подписке OpenCode Go за $10 в месяц, через OpenRouter и ещё в десятке мест. Название модели везде одно, а что стоит за ним, снаружи не видно. Это те же веса или квантованная копия? Насколько быстро она отвечает? Что будет с кешем, с рассуждением, с вызовом инструментов?
У меня есть аккаунт DeepSeek и подписка OpenCode Go, на Ollama Cloud я пополнил баланс. Прежде чем решать, куда отправлять основную нагрузку, захотелось померить. Тесты по моему заданию собрал и прогнал Claude Code, я задавал вопросы и проверял выводы.
Короткий ответ: по качеству все три провайдера отдают одну и ту же модель, разница не выходит за пределы шума. Различаются они скоростью, и сильно.
Что обещают провайдеры
| DeepSeek | Ollama Cloud | OpenCode Go | |
|---|---|---|---|
| Имя модели | deepseek-flash | deepseek-v4.1-flash | deepseek-v4.1-flash |
| Вход / кеш / выход за 1M токенов | $0.30 / $0.006 / $1.20 | $0.30 / $0.006 / $1.20 | подписка, $10 в месяц |
| Скидка 50 % | вне 01–04 и 06–10 UTC в будни | вне 12–18 UTC в будни | — |
| Параллельных запросов | 2500 | 3 без подписки | не указано |
| Лимит | баланс | баланс | ~43 тыс. запросов за 5 часов |
У DeepSeek под именем deepseek-flash работает версия DeepSeek-V4.1-Flash-10171. У Ollama есть тариф Pay as you go без подписки: платишь за токены, ровно по цене DeepSeek2. Про веса Ollama пишет, что облачные модели работают на оригинальных весах, но на Blackwell могут использовать NVFP4. Это четырёхбитный формат, и он мог бы сказаться на качестве.
OpenCode Go не называет, кто на самом деле обслуживает модель. В документации есть строка про соглашение DeepSeek о нулевом хранении данных, а для модели нужно разрешить регион Global3. Это намёк на сам DeepSeek, но не утверждение.
Как тестировали
Все запросы шли с моего рабочего Mac через один и тот же локальный прокси, так что сетевая часть задержки у трёх провайдеров общая. Прогон шёл в среду, 11 ноября, с 13:10 до 14:20 UTC, по 995 запросов на провайдера. Запросы потоковые, по тому же OpenAI-совместимому /chat/completions с одинаковым телом. Время до первого токена и скорость вывода считались на стороне клиента. Всё, что модель отдаёт до ответа, включая рассуждение, считается выводом.
Параллельно шло не больше трёх запросов на провайдера, это предел Ollama без подписки.
Задачи выбирали по двум правилам. Первое: ответ проверяется программой, а не другой моделью или моим впечатлением. Второе: вместе наборы покрывают то, ради чего я вообще пользуюсь Flash, — агента, который пишет код, рассуждает, вызывает инструменты и держит длинный контекст. Если провайдер где-то портит модель, это должно проявиться хотя бы в одном из режимов.
Короткие ответы для замера скорости
15 запросов вида «объясни, как работает DNS, примерно в 400 словах» на разные темы, без рассуждения. Проверять в них нечего, они нужны только для времени. Короткий промпт убирает из замера разбор входа, а ответ в 450 токенов достаточно длинный, чтобы скорость вывода успела установиться. Каждый запрос начинался со случайного числа, чтобы ни один провайдер не отдал ответ из кеша.
Длинный контекст
Шесть синтетических документов по 65 тысяч токенов: 3300 строк вида «Entry 1234: the maple station recorded 512 units of quartz on day 87». Где-то посередине спрятана строка с шестизначным кодом, и в конце модель просят этот код назвать. Место строки в документах разное, от 15 до 85 % длины.
Агенту приходится каждый ход отправлять всю историю беседы, и на длинных сессиях это десятки тысяч токенов. Поэтому важно, как быстро провайдер разбирает такой промпт и работает ли у него кеш. Каждый документ отправлялся дважды подряд: первый запрос показывал холодный разбор, второй — повтор из кеша. Сам поиск кода для модели такого уровня лёгкий, он проверял только, что провайдер не обрезает контекст.
MMLU-Pro
MMLU-Pro4 — 12 032 вопроса с выбором ответа по 14 областям, от права и экономики до физики и информатики. Это усложнённая версия классического MMLU: больше половины вопросов взяты оттуда, но у пяти из шести вопросов десять вариантов ответа, а не четыре, и угадать труднее. Пример из информатики: даны три строки Java, "CARROT", "Carrot" и "car", нужно выбрать, какое из восьми выражений с compareTo истинно.
Я взял 300 случайных вопросов со всех областей и попросил ответить одной буквой, без рассуждения и с temperature: 0. Каждый провайдер прошёл их дважды.
Главное в этом наборе — сравнение ответов. Ответ здесь — одна буква, поэтому ответы двух провайдеров можно сравнить вопрос за вопросом, а не только по итоговому проценту. Без рассуждения модель отвечает сразу и не может поправить себя по ходу. Мне кажется, что так расхождение в весах скорее проявится прямо в выборе буквы, но это допущение, а не проверенный факт. А ещё такие запросы дешёвые: 600 ответов обошлись примерно в 3 цента на провайдера.
HumanEval
HumanEval5 — 164 задачи на Python от OpenAI. В каждой дан заголовок функции с docstring и парой примеров, модель пишет тело. Например, truncate_number(3.5) должна вернуть дробную часть, 0.5. К каждой задаче приложены тесты, в среднем восемь проверок.
Код модели запускался вместе с тестами в контейнере python:3.13-slim без сети, с read-only корнем, лимитом памяти в 1 ГБ и таймаутом 15 секунд на задачу. Задача решена, если все проверки прошли.
Код — моя основная нагрузка, поэтому набор обязательный. Его слабость в том, что он старый и простой: сильные модели решают почти всё, и мелкую разницу он не покажет. Зато грубую поломку, например обрезанный ответ или испорченное форматирование кода, он поймает сразу.
AIME
AIME — американская олимпиада по математике для старшеклассников. За год проходят два тура по 15 задач, ответ всегда целое число от 0 до 999. Я взял все 30 задач 2024 года6 и все 30 задач 2025 года7: комбинаторика, алгебра, геометрия, теория чисел. Пример из 2025 года: найти сумму всех целых оснований b > 9, для которых 17 в системе счисления b делит 97 в той же системе. Ответ 70.
Здесь модель работает с рассуждением, и на одну задачу в медиане уходит около 3500 токенов. Ошибка в любом месте длинной цепочки ломает ответ, поэтому порча модели здесь должна накапливаться. Длинные ответы дают и самый честный замер скорости вывода. Модель пишет итоговый ответ внутри LaTeX-команды \boxed{}, как принято в математических наборах, например \boxed{70}. Программа берёт оттуда число и сверяет с эталоном. Каждый провайдер решал все 60 задач дважды.
Эти задачи опубликованы, и модель могла видеть их при обучении, поэтому абсолютный процент надо читать осторожно. Но для сравнения провайдеров это неважно: модель у всех одна, и знает она одно и то же.
Вызов инструментов
12 сценариев с пятью инструментами: погода, конвертация валют, событие в календаре, поиск файлов и письмо. Половина запросов на русском. Например, «Поставь встречу «Ревью бюджета» завтра в 15:30 на полтора часа» должен превратиться в create_event с датой 2026-11-12, временем 15:30 и длительностью 90. В двух сценариях инструмент не нужен, «сколько будет 12 умножить на 12», и модель не должна его вызывать. Каждый сценарий шёл с рассуждением и без, по три раза.
Этот набор проверяет не столько модель, сколько провайдера. Вызов инструмента — формат поверх текста, и посредник может разбирать его своим кодом. Если разбор сломан, агент перестаёт работать, хотя по тексту модель отвечает правильно.
Скорость
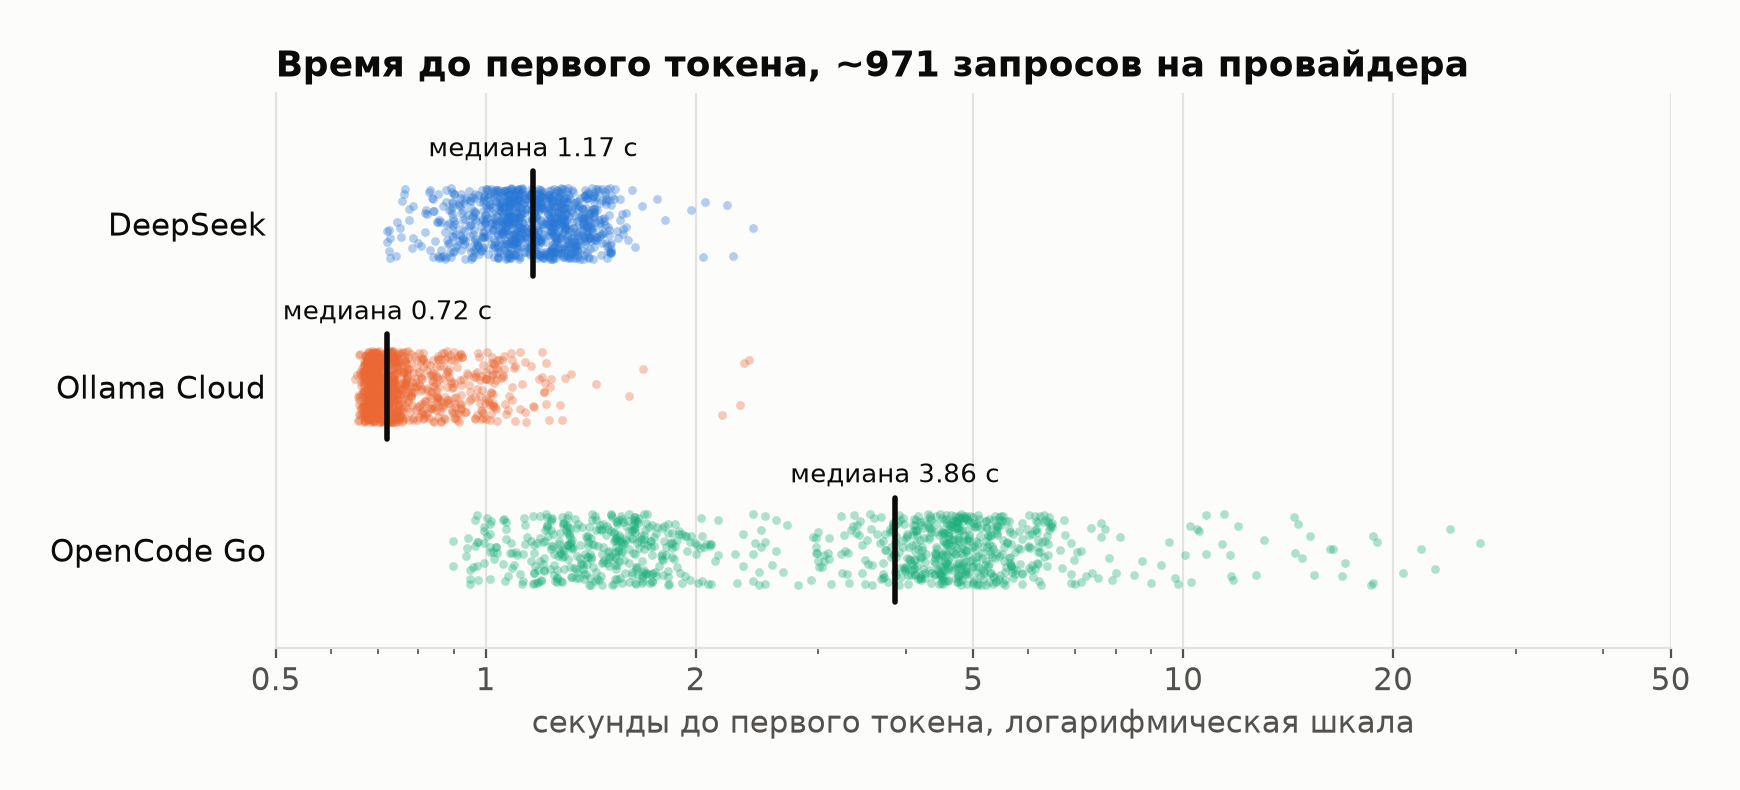
Ollama Cloud отвечает первым: в медиане через 0.72 с, почти без хвоста. DeepSeek стабильно укладывается в 1–1.5 с. OpenCode Go в медиане отвечает через 3.9 с, а заметная часть запросов ждёт 10–25 с.
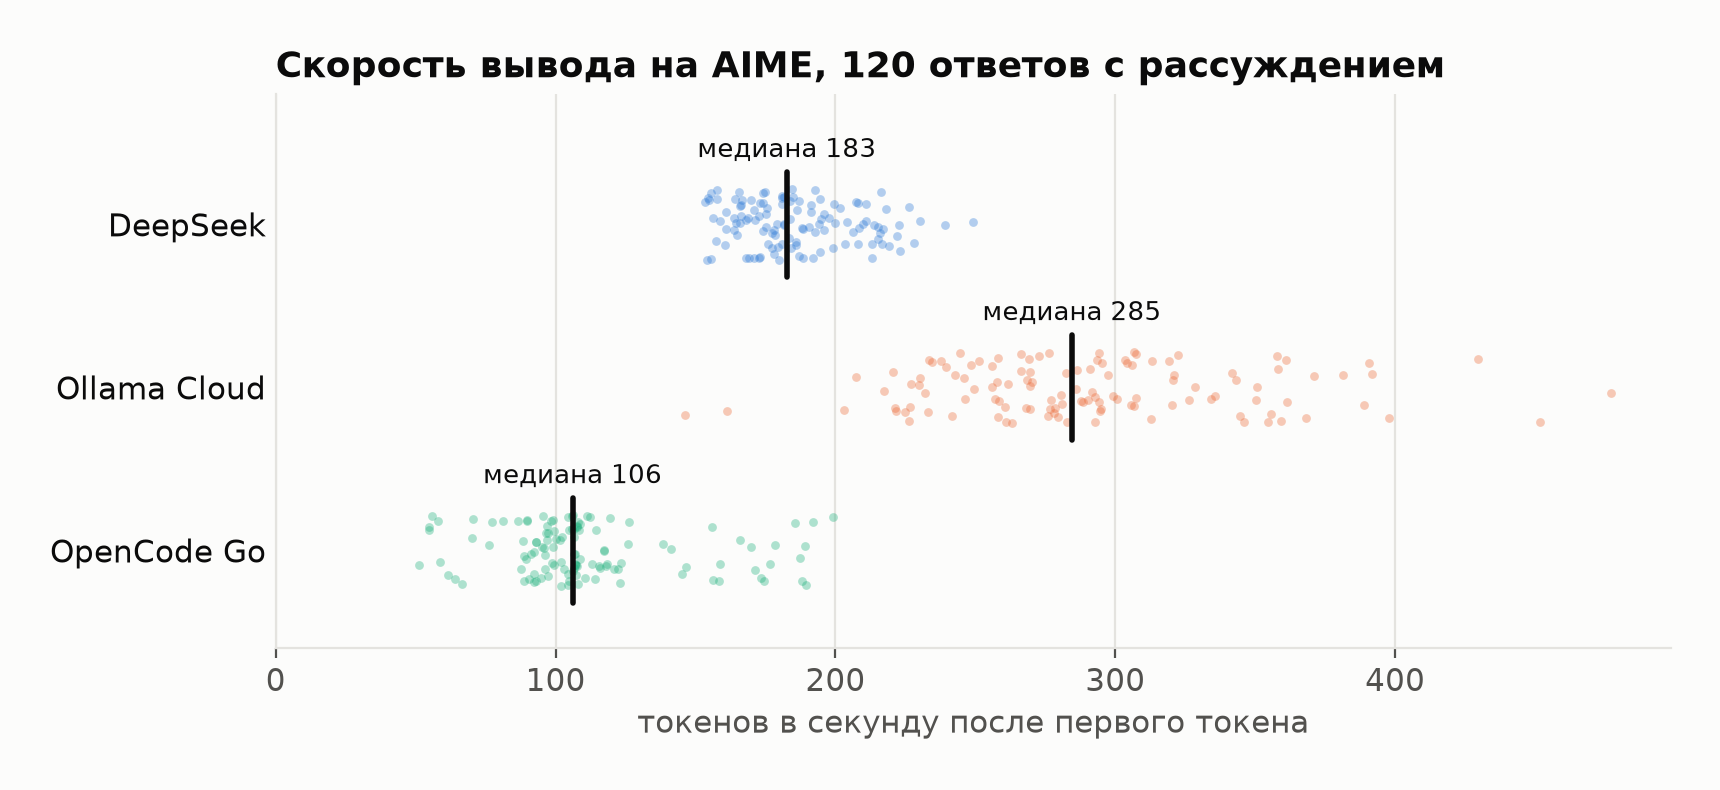
Скорость вывода на длинных ответах с рассуждением: у Ollama 285 токенов в секунду, у DeepSeek 183, у Go 106.
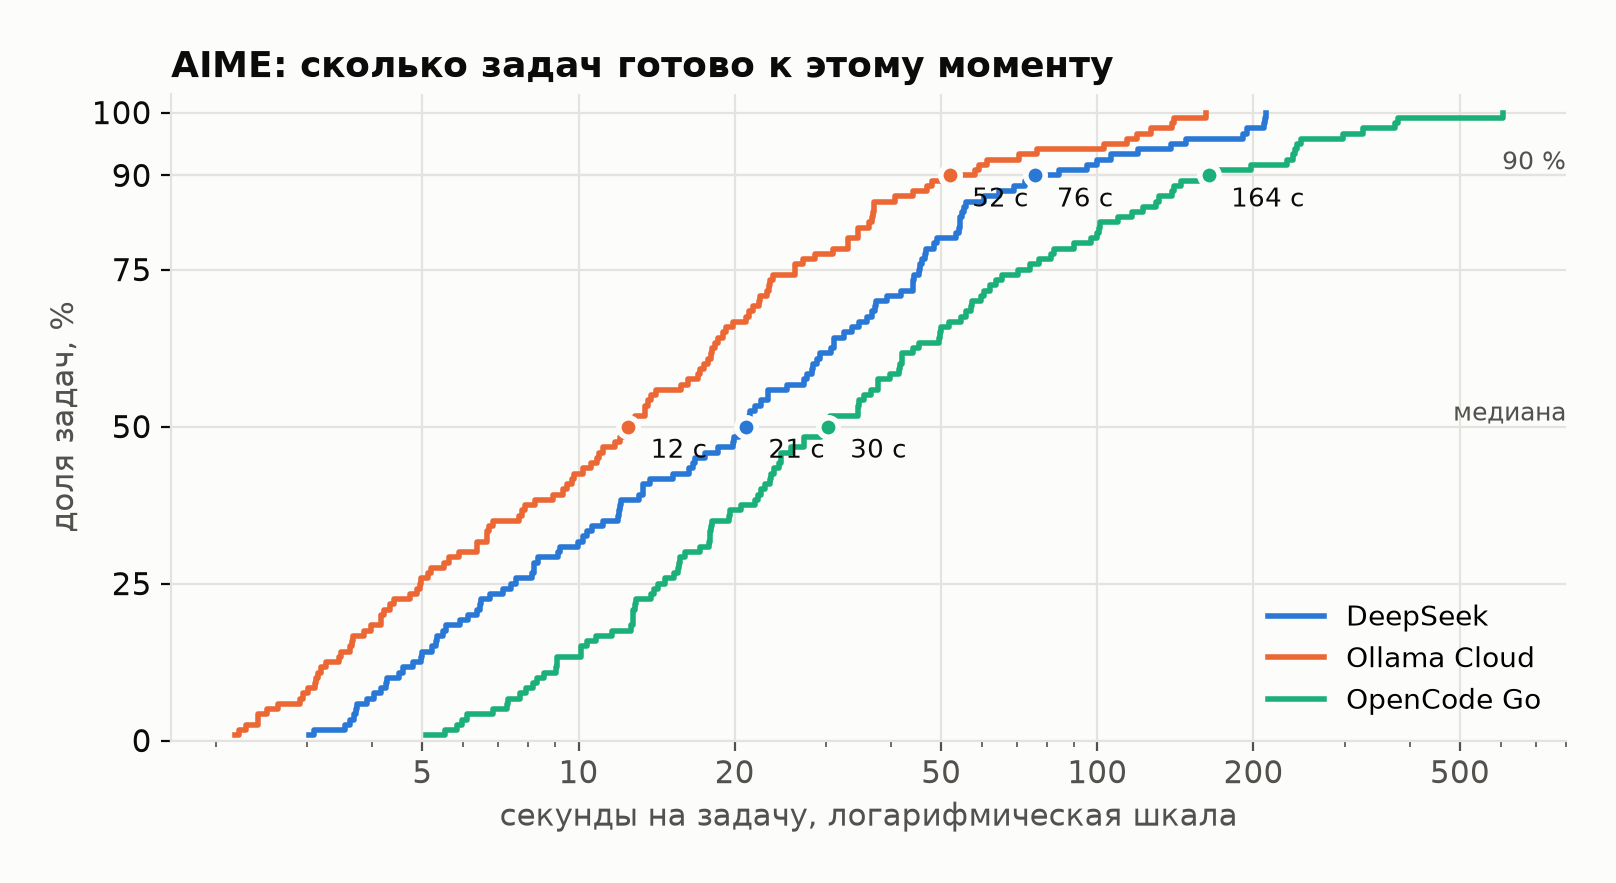
Хорошо это видно на AIME. Половину задач Ollama решил за 12 с, DeepSeek за 21 с, Go за 30 с. До 90 % задач Ollama добрался за 52 с, DeepSeek за 76 с, а Go за 164 с. Суммарно 120 задач заняли 47 минут запросов у Ollama, 72 у DeepSeek и 131 у Go.
| Набор | Метрика | DeepSeek | Ollama | OpenCode Go |
|---|---|---|---|---|
| Короткий промпт, без рассуждения | до первого токена | 1.18 с | 0.70 с | 4.60 с |
| токенов в секунду | 128 | 194 | 71 | |
| AIME, с рассуждением | до первого токена | 1.20 с | 0.74 с | 4.48 с |
| токенов в секунду | 183 | 285 | 106 | |
| Промпт 65 тыс. токенов | первый запрос | 2.5 с | 3.5 с | 3.3 с, хвост до 82 с |
| повтор из кеша | 1.9 с | 1.5 с | 2.6 с |
Длинный промпт DeepSeek разбирает быстрее всех и ровнее всех. В таблице второй прогон. В первом холодный разбор у Ollama занимал в медиане 12 с, у Go 9 с, а во втором, через несколько минут, у Ollama 2–5 с. Похоже на колебания нагрузки, но двух прогонов мало, чтобы это утверждать.
Качество
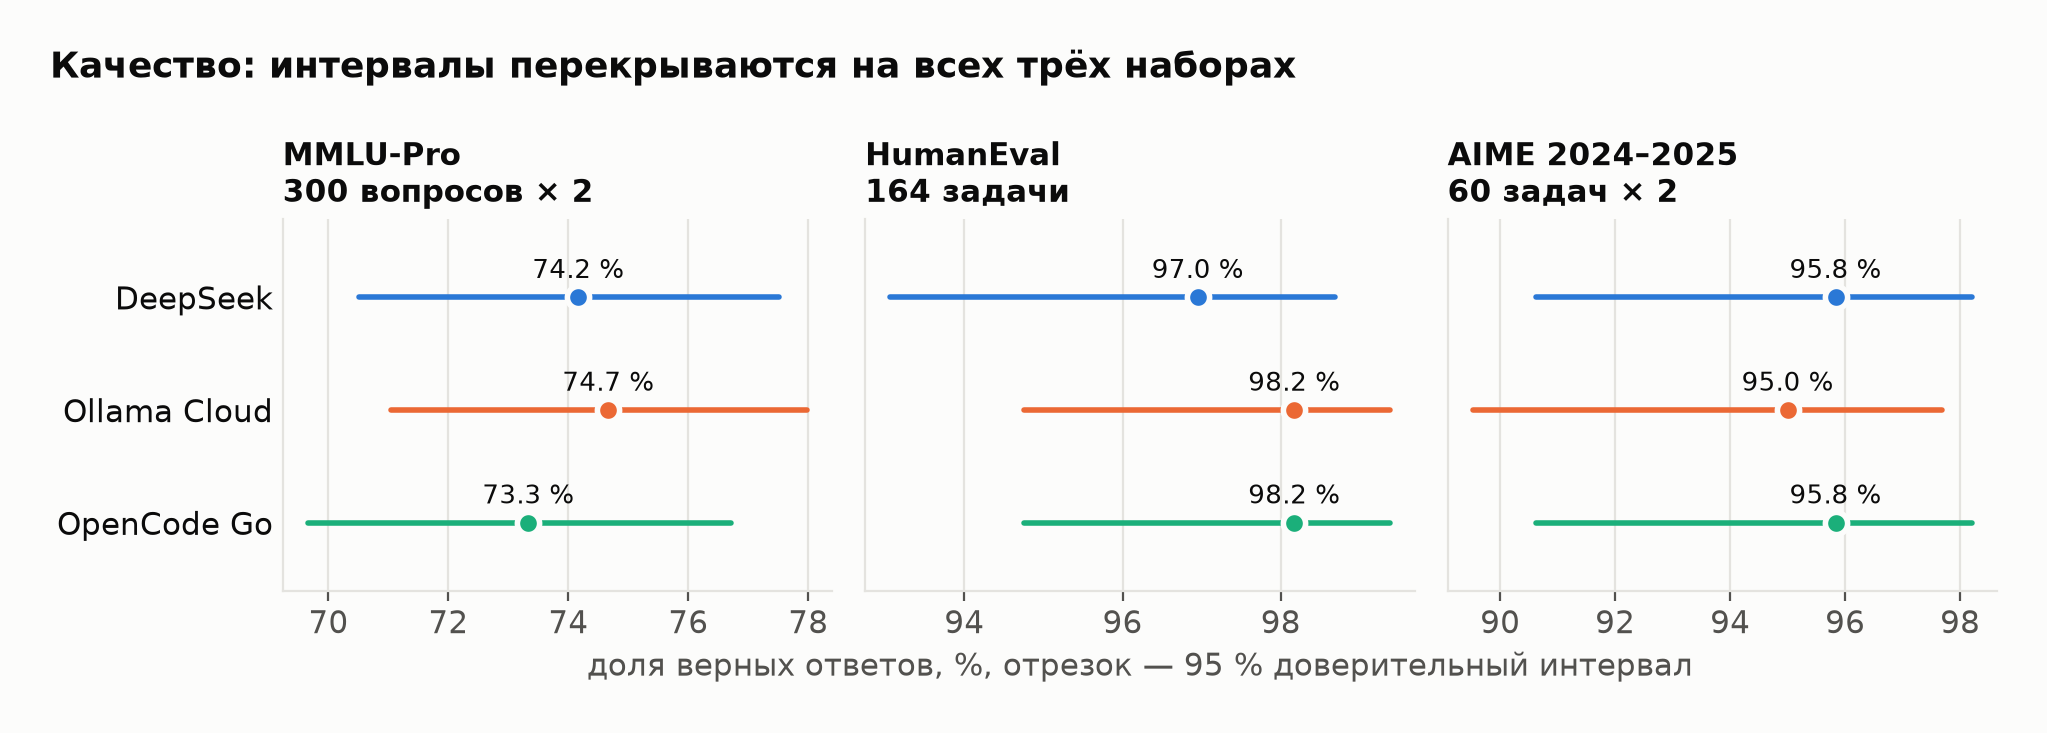
| Набор | DeepSeek | Ollama | OpenCode Go |
|---|---|---|---|
| MMLU-Pro, 600 ответов | 74.2 % | 74.7 % | 73.3 % |
| HumanEval, 164 задачи | 97.0 % | 98.2 % | 98.2 % |
| AIME, 120 решений | 95.8 % | 95.0 % | 95.8 % |
| Вызов инструментов, 72 запроса | 72 | 72 | 72 |
| Код в контексте 65 тыс. токенов, 24 запроса | 24 | 24 | 24 |
Интервалы перекрываются везде. На HumanEval провайдеры разошлись в четырёх задачах из 164, и каждый раз в разную сторону. Две задачи не решил никто.
Точность — грубый инструмент: при 300 вопросах погрешность около 1.5 процентного пункта, и деградацию на пару пунктов она не покажет. Поэтому на MMLU-Pro я сравнивал сами ответы.
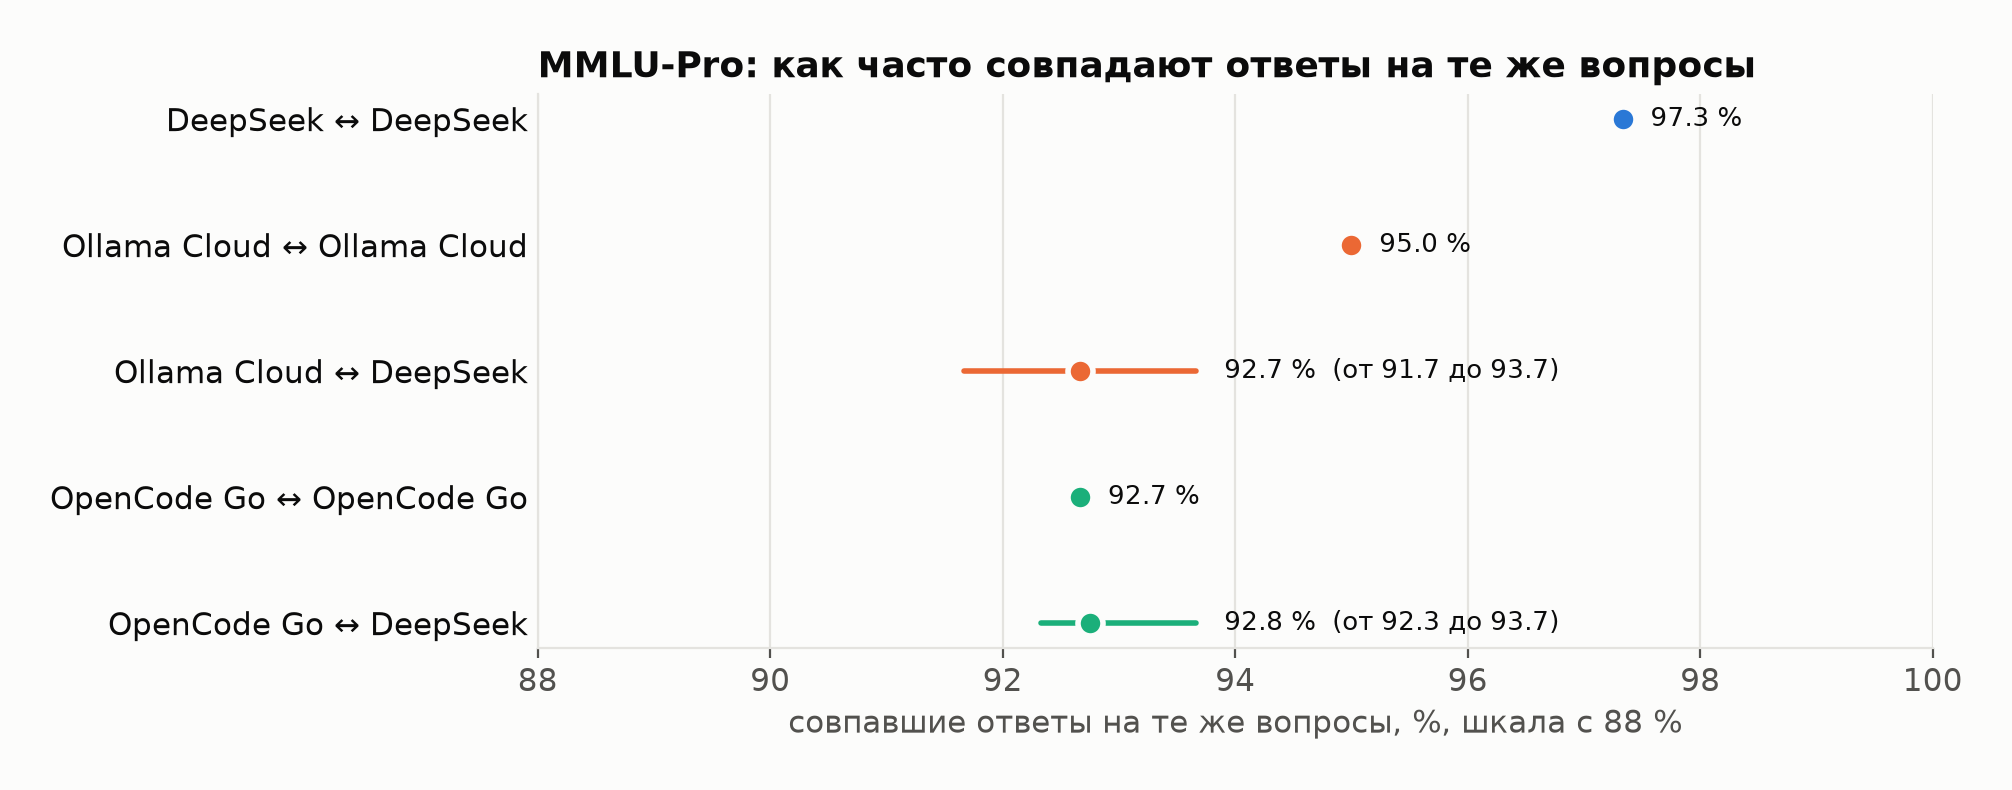
DeepSeek сам с собой между двумя прогонами совпал в 97.3 % вопросов. Ollama сам с собой совпал в 95 %, Go в 92.7 %. С DeepSeek оба посредника совпадают одинаково, около 92.7 %. Это ниже, чем DeepSeek совпадает сам с собой, но ровно столько, сколько даёт собственный разброс Go. Я читаю это так: посредники отвечают менее детерминированно, а модель у них та же. Прямо замер этого не доказывает, но заметно испорченная модель, скорее всего, расходилась бы с эталоном сильнее, чем остальные.
Сразу возникает вопрос, почему при temperature: 0 ответы вообще расходятся. Я проверил отдельно, доходит ли параметр до модели. При нуле восемь просьб «назови случайное число от 1 до 1000» дали у всех трёх провайдеров одно и то же число 427, при 1.5 — шесть-семь разных. Параметр работает, просто нулевая температура не делает ответ детерминированным: восемь коротких рассказов при нуле даже у самого DeepSeek оказались восемью разными текстами. У посредников разброс больше, но на точности это не сказывается.
Что нашлось по дороге
Ollama не выключает рассуждение так, как DeepSeek. У DeepSeek и Go это делает "thinking": {"type": "disabled"}8. Ollama этот параметр и think: false молча игнорирует и продолжает рассуждать. Выключает только reasoning_effort: "none". Клиент, настроенный под DeepSeek, на Ollama будет тратить токены на рассуждение там, где его не просили.
Кеш у Go работает только со стабильной сессией. Go просит слать заголовок x-opencode-session с одним значением на всю беседу. Первый прогон длинного контекста я сделал с новым значением на каждый запрос, и повтор 65-тысячного промпта шесть раз из шести прошёл мимо кеша. С одним значением на документ кеш сработал шесть раз из шести. Claude Code и Hermes этот заголовок шлют сами, а самописному клиенту про него надо помнить.
У Go несколько бэкендов. Объект usage в ответах Go приходит в трёх разных формах, одна из них с полями OpenAI вроде audio_tokens. Формы различаются и задержкой:
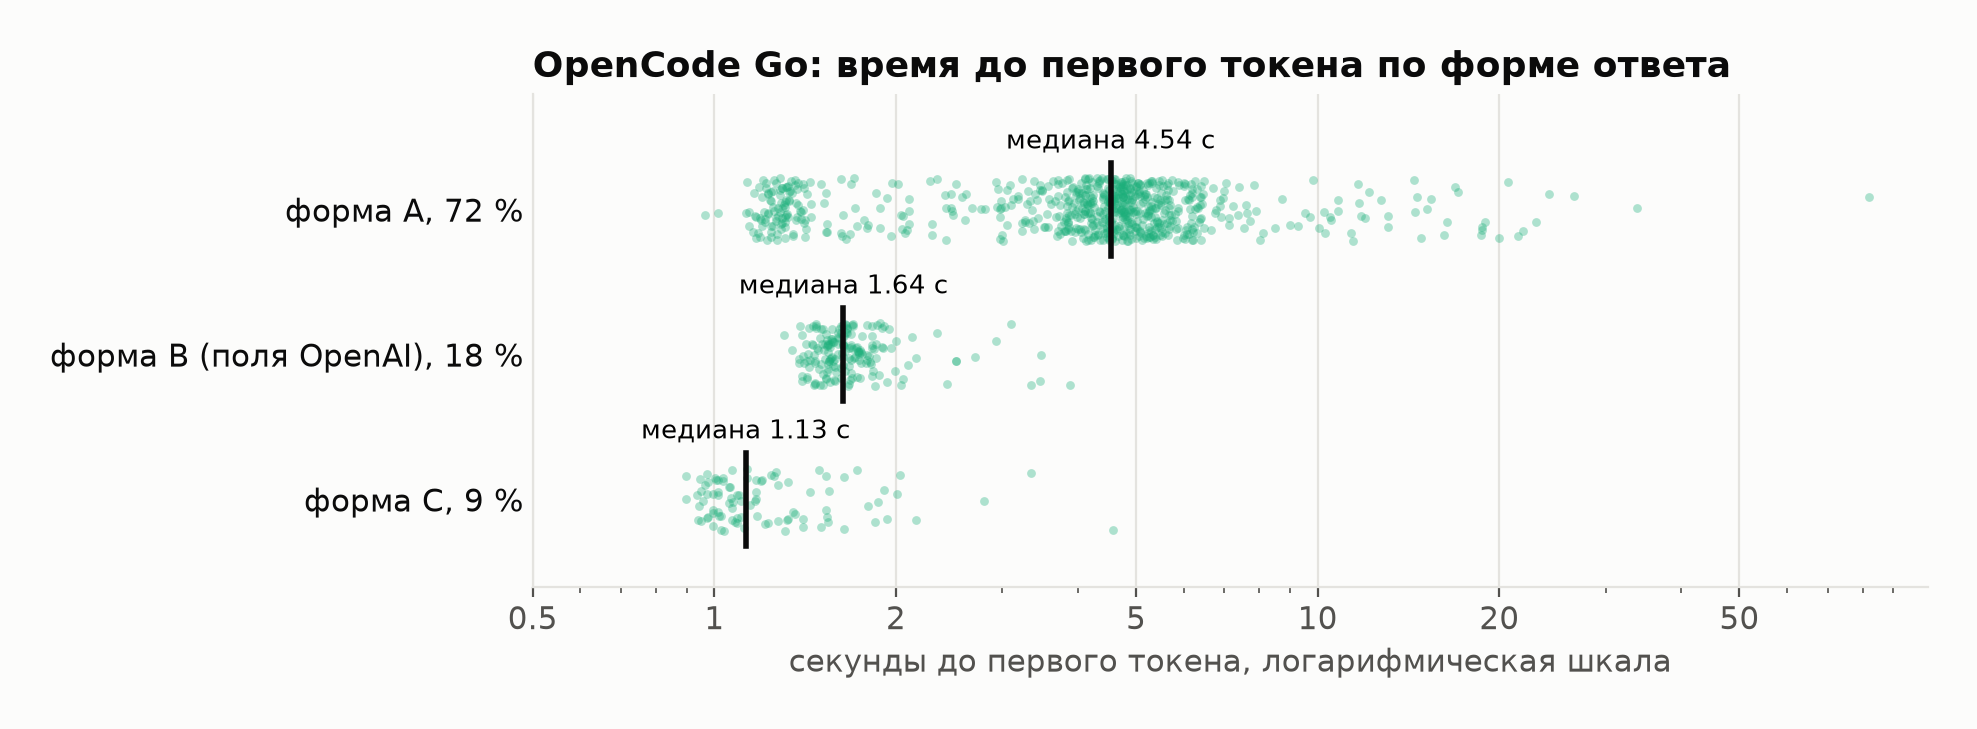
72 % запросов попали в форму A с медианой 4.5 с, остальные отвечали за 1.1–1.6 с. Внутри формы A тоже видны две группы, около 1.3 с и около 5 с. Похоже, Go раскидывает запросы по нескольким поставщикам, и от того, куда попал запрос, зависит его скорость. Это вывод по форме ответов, сам Go поставщиков не называет. Точность по формам одинакова в пределах шума.
Посредники пересобирают ответ. DeepSeek отдаёт аргументы вызова инструмента с пробелами, {"city": "Берлин"}, а Ollama и Go компактно, {"city":"Берлин"}. Значит, оба разбирают ответ модели и собирают его заново. Нормальный клиент этого не заметит.
Go считает цену по тарифу DeepSeek. В ответах Go есть поле usage.opencode.list_cost, сколько запрос стоил бы без подписки. В проверенных запросах оно до последнего знака совпало с тарифом DeepSeek со скидкой: прогон пришёлся на часы скидки DeepSeek.
Токены промпта совпадают. На коротких запросах все три провайдера насчитывают одинаковое число токенов промпта, до единицы. На запросах с рассуждением и на длинном контексте Ollama насчитывает на один токен больше.
Ограничения
Это один день и одна точка подключения, к тому же через прокси. Чтобы понять, сколько добавляет прокси, я через полтора часа повторил короткие запросы и длинный контекст напрямую. Прямой выход шёл через Испанию, а прокси выходил в Нидерландах, так что это два разных маршрута, а не замер одного прокси. Напрямую первый токен приходил на 0.1–0.25 с раньше: у DeepSeek в медиане 0.96 с вместо 1.18, у Ollama 0.58 вместо 0.70, у Go 4.36 вместо 4.60. Скорость вывода не изменилась, а порядок провайдеров остался тем же. Медленный первый токен у Go сетью не объясняется. По 6–15 запросов на скоростные наборы хватает, чтобы увидеть порядок, но не тонкую разницу. На DeepSeek прогон пришёлся на часы скидки, когда нагрузка у него, вероятно, ниже; у Ollama, наоборот, на часы полной цены. Деградацию качества меньше пары пунктов этот замер не отличает от шума. Три запроса к DeepSeek упали на TLS через прокси и прошли с повтора, у Ollama и Go ошибок не было.
Весь замер стоил около 0.76 млн выходных и 1–1.4 млн входных токенов на провайдера, порядка $1.2–1.3 по полной цене.
Что из этого следует
Модель у всех одна, и выбирать приходится по скорости, цене и удобству. Ollama Cloud оказался самым быстрым при той же цене за токен, что у DeepSeek, но без подписки у него три параллельных запроса и своё расписание скидок. DeepSeek самый предсказуемый: без хвостов, с быстрым разбором длинного промпта и честным кешем. OpenCode Go за $10 в месяц даёт тысячи запросов, но платить за это приходится временем: медленный первый токен, низкая скорость вывода и хвосты, которые в агентной работе складываются в минуты.
Models & Pricing, DeepSeek API Docs, на 11 ноября 2026. ↩︎
Ollama Pricing и страница модели deepseek-v4.1-flash, на 11 ноября 2026. ↩︎
OpenCode Go, документация: модели, лимиты, приватность и заголовок
x-opencode-session. ↩︎TIGER-Lab/MMLU-Pro, тестовая выборка, 300 вопросов со случайным зерном 42. ↩︎
Thinking Mode, DeepSeek API Docs. ↩︎