Perigee: своя читалка и разреженные строки
Я пишу читалку для Android, она называется Perigee1. Сегодня вышла v0.1.0-rc52, и главное в ней — страницы без дыр между словами. Ниже расскажу, зачем понадобилась своя читалка, откуда берутся разреженные строки, какие способы мы перебрали и почему ни один готовый алгоритм не подошёл целиком.
Исследование вели два агента, Hermes и Claude Code. Я смотрел на страницы и принимал решения.
Зачем своя читалка
Книги у меня лежат на собственном сервере bookOrbit3. Он хранит библиотеку и прогресс чтения, у него есть веб-читалка, а официального приложения для Android, когда я начинал, не было.
Читать на телефоне мне нравится в ReadEra: она хорошо показывает текст и ею просто пользоваться. Но с bookOrbit она не синхронизируется. KOReader синхронизируется и даёт отличный движок, только настроек в нём столько, что читалка становится отдельным хобби.
Отсюда и цели Perigee:
- Отображение важнее всего. Текст верстает crengine4, нативный движок KOReader: переносы по словарю языка книги, выравнивание по ширине, висячая пунктуация, сноски внизу страницы.
- Просто, как в ReadEra. Настройки повторяют её набор: шрифт, размер, интервалы, поля. Сразу видно, как изменение меняет страницу.
- Самостоятельное приложение. Локальная библиотека и каталоги OPDS работают без сервера.
- Полная синхронизация с bookOrbit. В обе стороны ходят место чтения, выделения с заметками, закладки, статус и оценка, на сервер уходит время чтения.
PDF, DjVu, комиксов и аудиокниг нет: для них нужен второй движок. Первый коммит появился 12 октября, в репозитории Kotlin и Compose поверх C++ движка.
Проблема
Первые сборки выглядели хорошо, но кое-где между словами зияли дыры. Вот самая плохая строка из тестовой книги, слева:
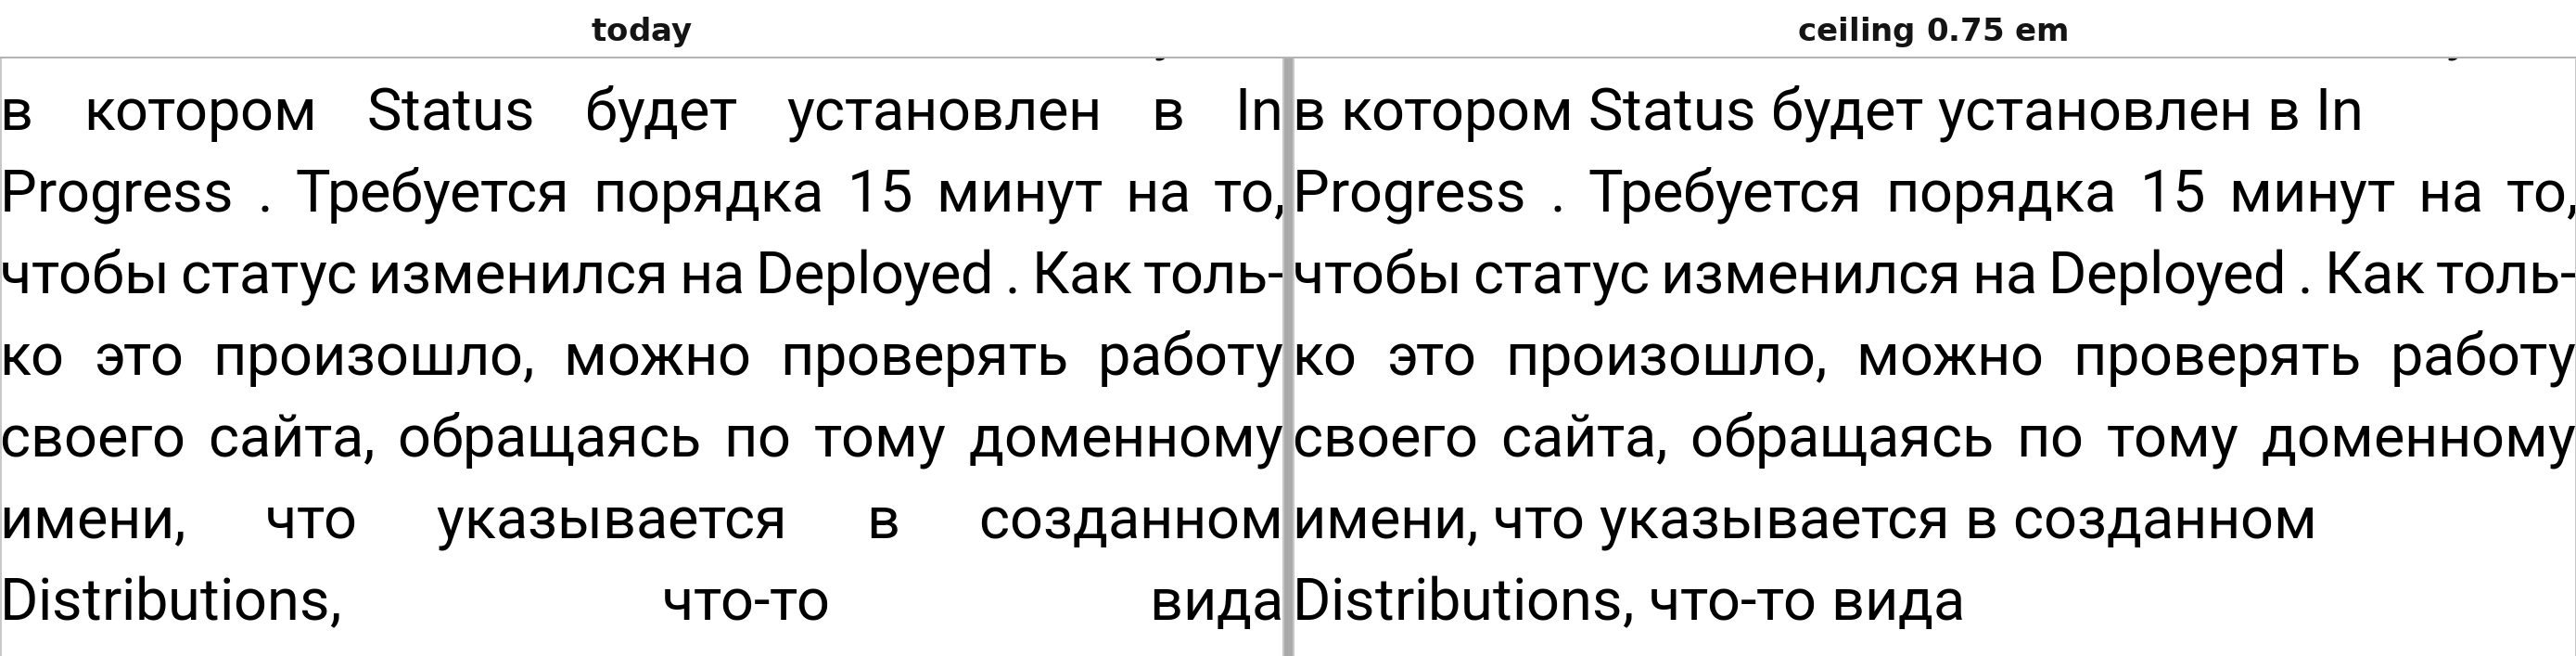
Причина в том, как движок выравнивает текст. Он жадный: набирает в строку столько, сколько влезает, а остаток ширины поровну делит между промежутками. У сжатия есть предел, в Perigee пробел нельзя ужать меньше чем до 75 %. У растяжения предела нет. Если следующее слово длинное и не переносится, вся пустота достаётся промежуткам этой строки.
Я попросил это померить. Промежутки считали в em, это размер шрифта: у шрифтов из приложения собственный пробел занимает 0.20–0.29 em. Hermes собрал crengine на компьютере с патчами приложения и добавил запись в CSV на каждую выровненную строку. Книга для замера: 1800 абзацев моего блога, Roboto 18 dp на экране шириной 1440 пикселей, это около 42 символов в строке и примерно 13 300 строк.
| Показатель | Значение |
|---|---|
| Медианный промежуток | 0.35 em |
| 99-й перцентиль | 1.13 em |
| Самый широкий | 5.48 em |
| Строк шире 0.5 em | 20.0 % |
| Строк шире 0.75 em | 4.4 % |
Медиана в норме, плохо с хвостом. Цель из задачи звучала так: ни одного промежутка шире 0.75 em и не больше одной строки из пятидесяти шире 0.5 em5.
Что мы попробовали
Потолок
Самое простое решение: если промежуток в строке превысит потолок, строка не выравнивается и остаётся с естественными пробелами. Предел у пробела есть и в InDesign: по умолчанию он растягивается до 133 %6.
| Потолок | Строк без правого края | p99 | Самый широкий |
|---|---|---|---|
| нет | 0 | 1.13 em | 5.48 em |
| 0.75 em | 4.4 % | 0.71 em | 0.71 em |
| 0.5 em | 20.0 % | 0.50 em | 0.50 em |
На картинке выше потолок 0.75 em справа убрал дыру. Вот все три варианта на той же странице, а ниже обычная страница:
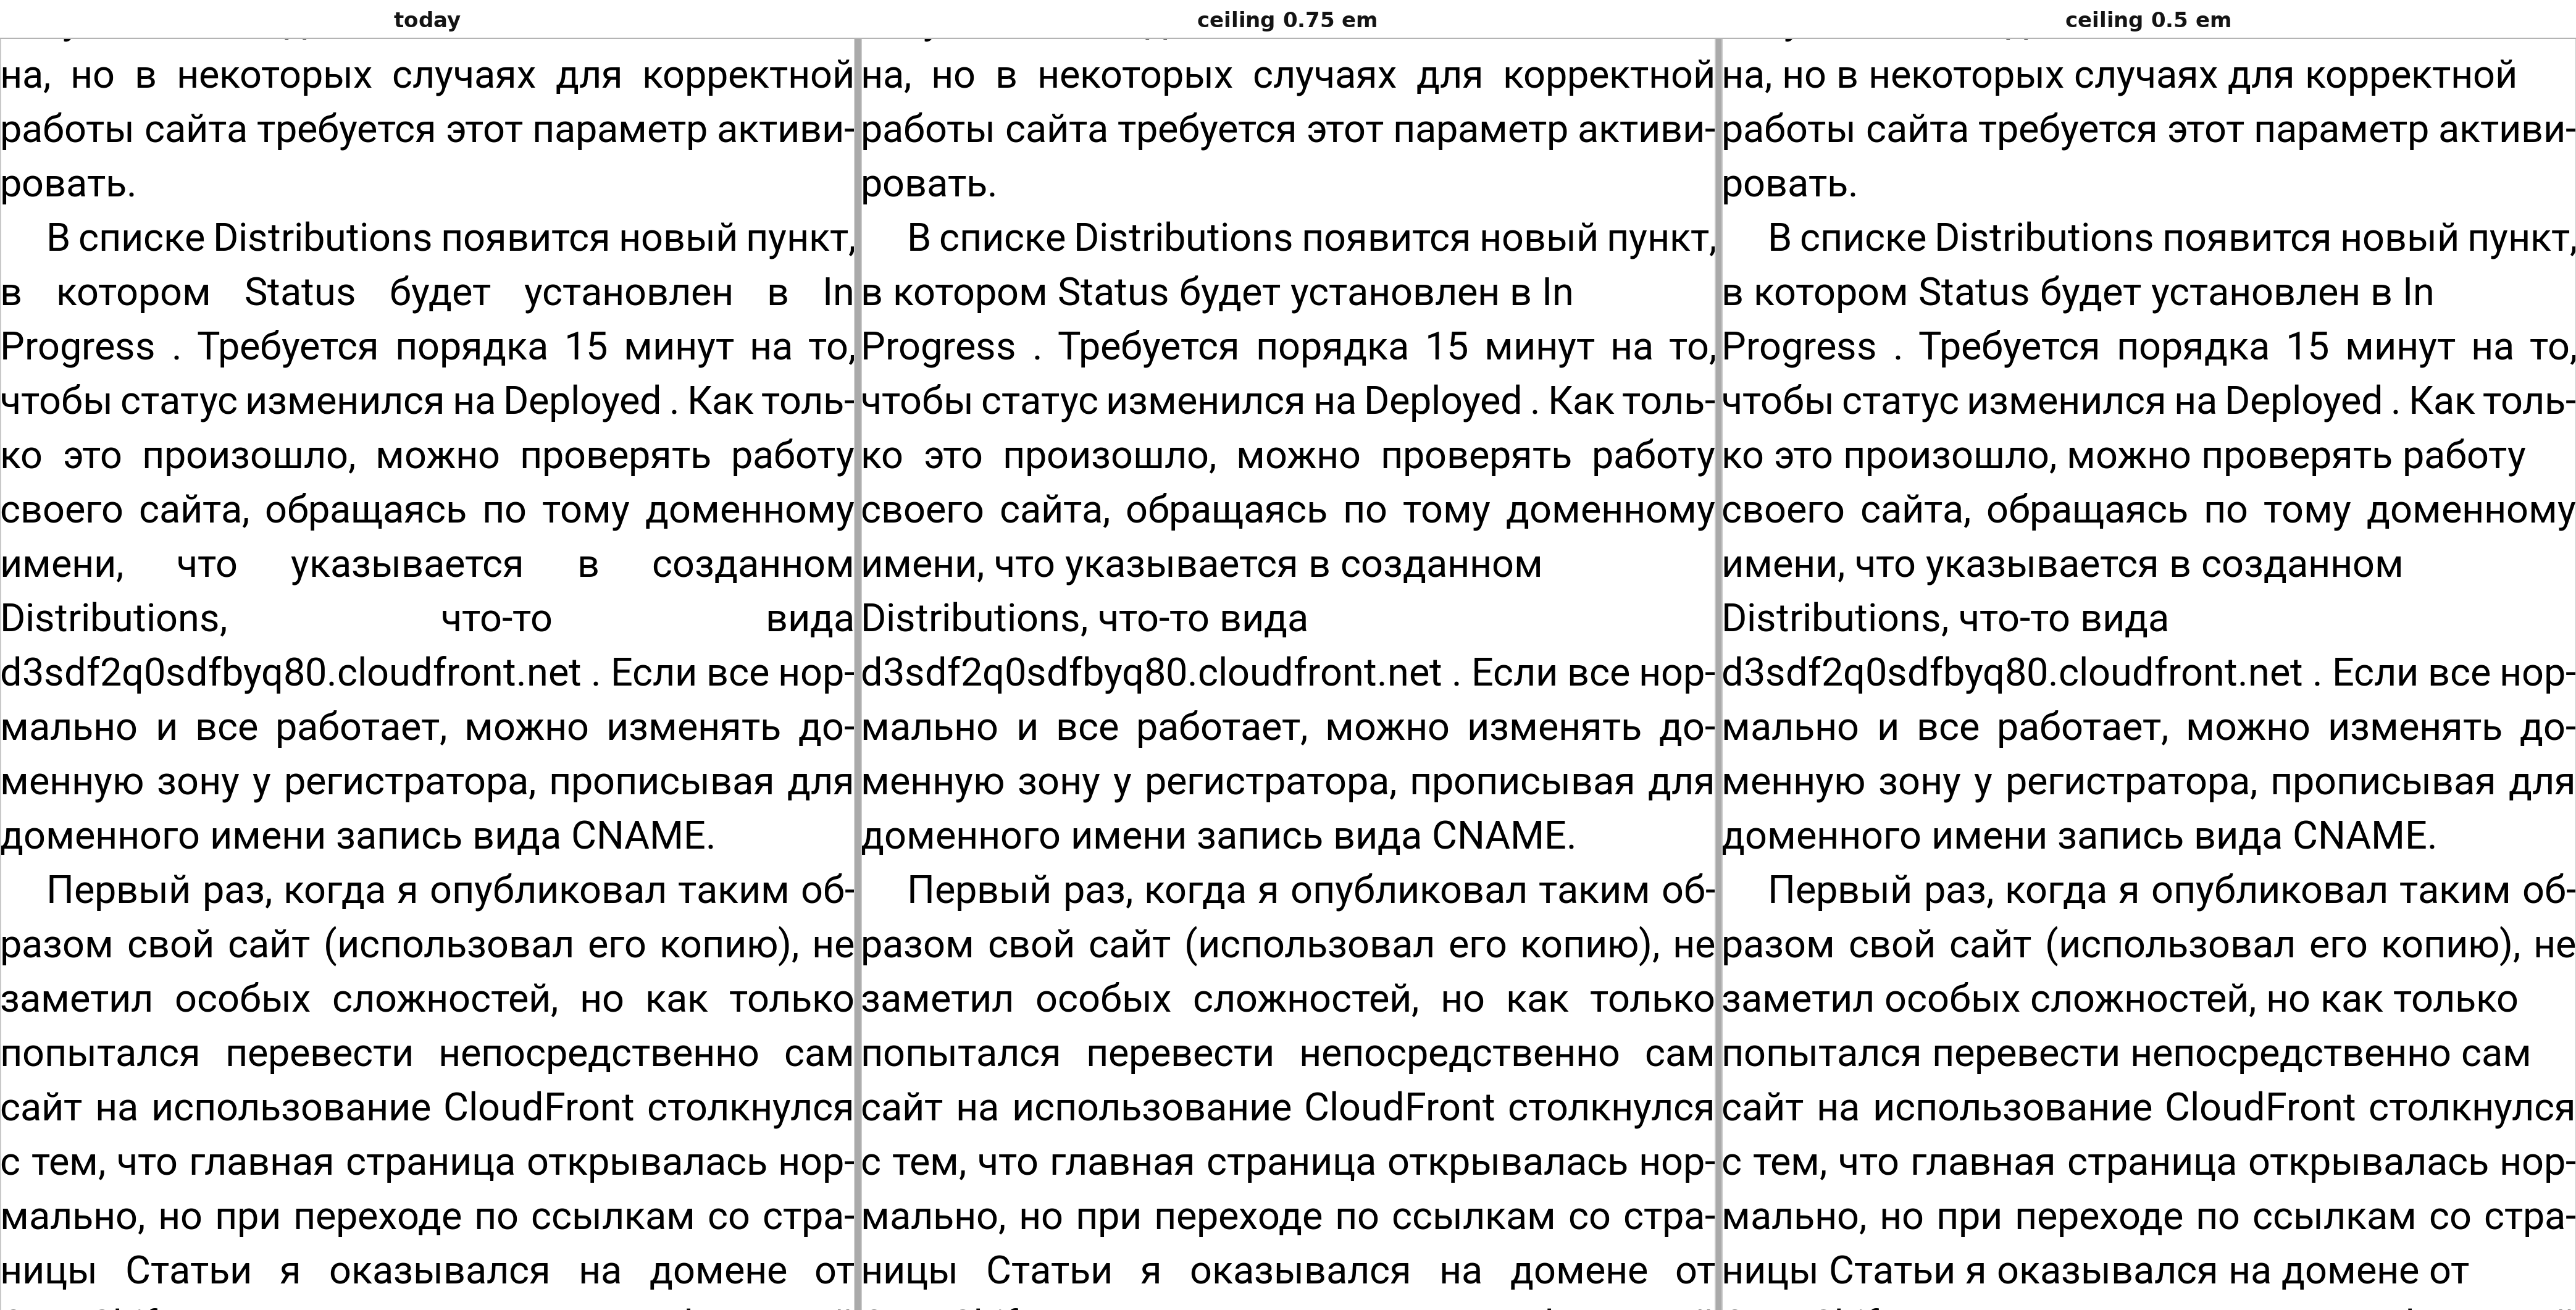
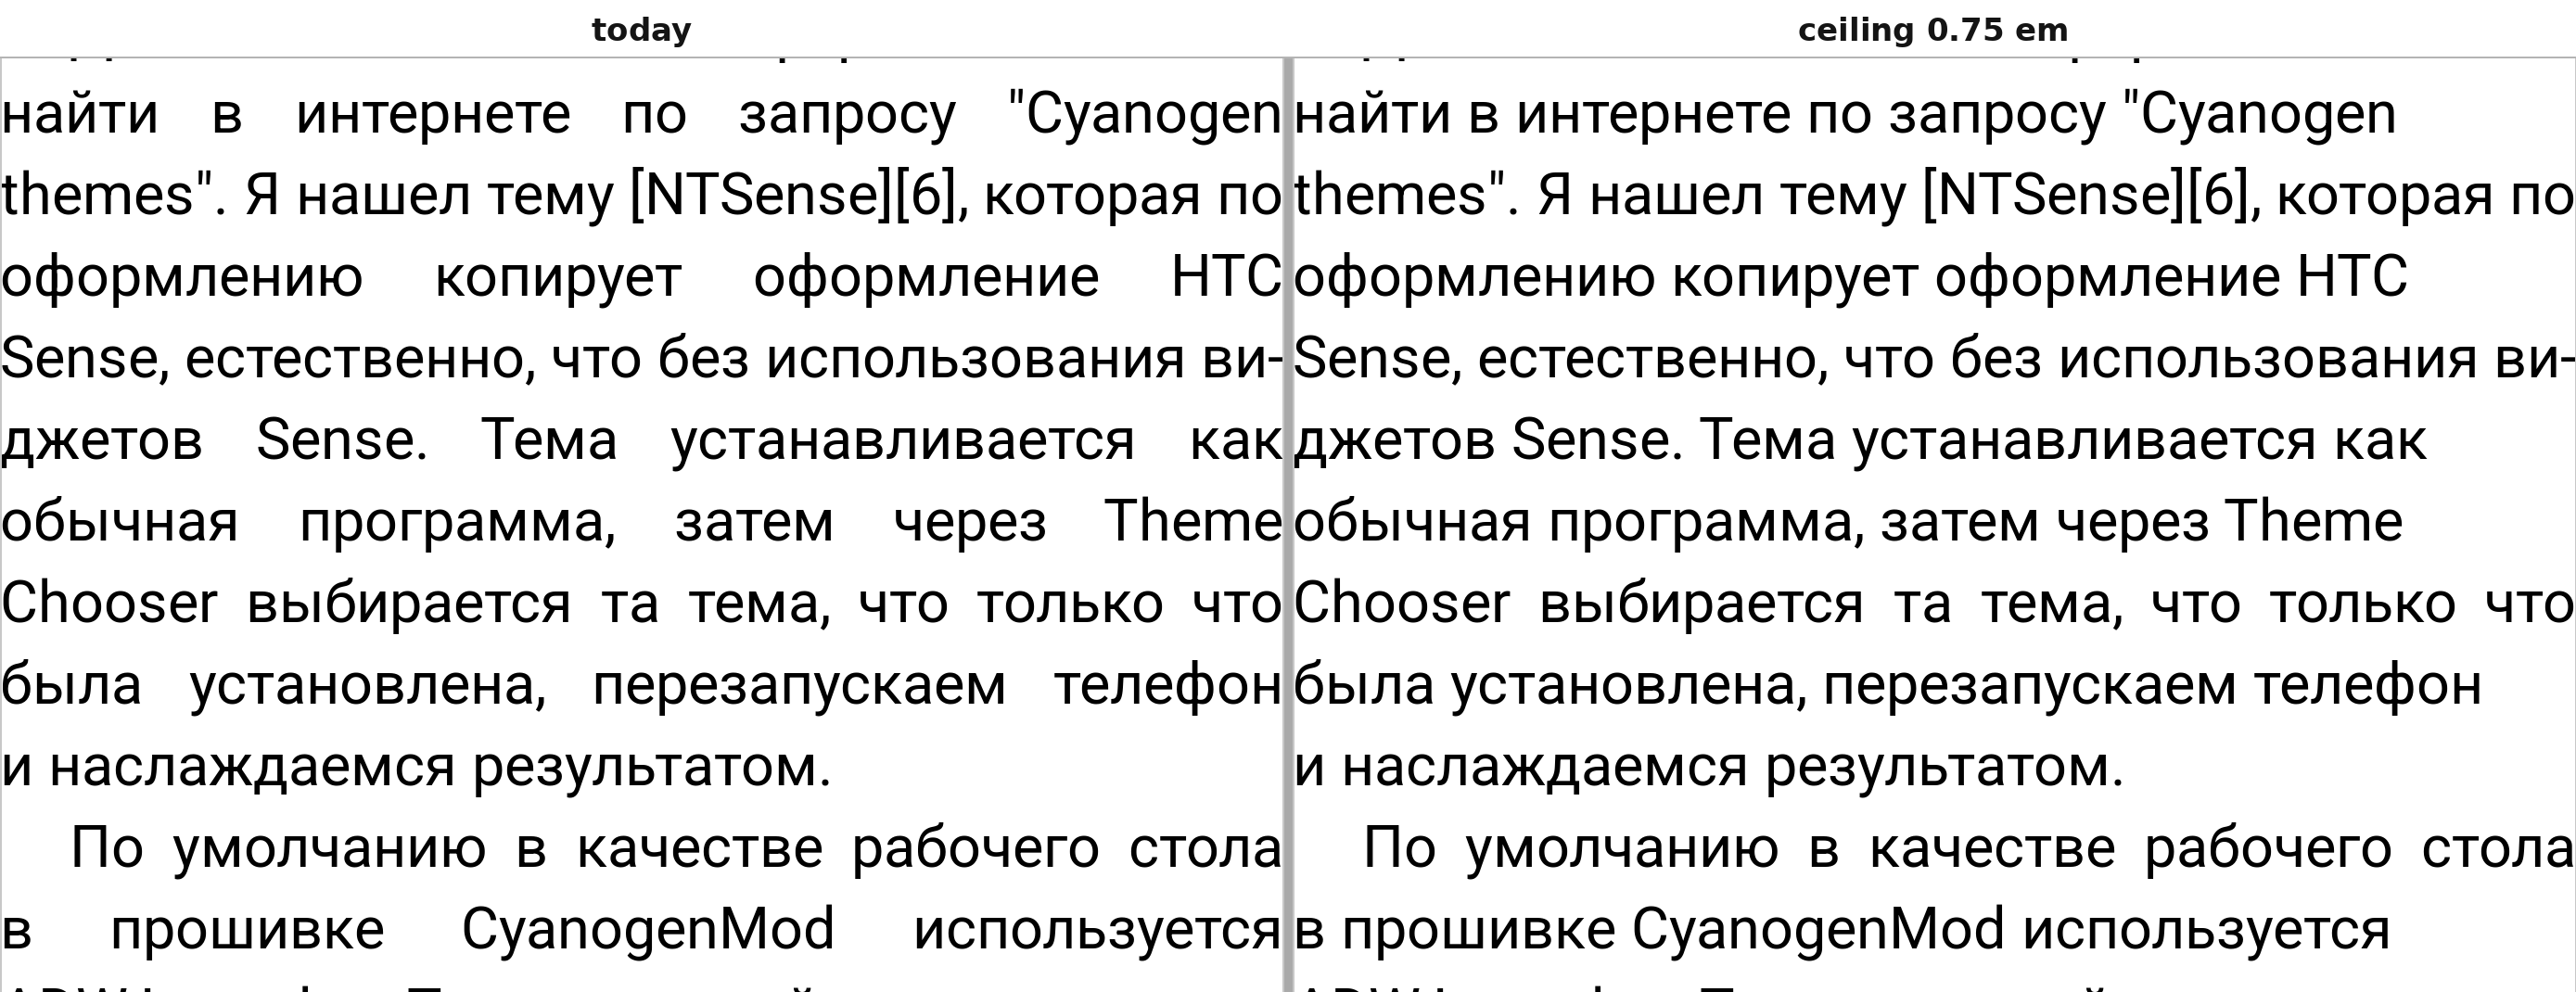
Дыры пропали, зато вместо них появились короткие строки посреди абзаца. На обычной странице таких было шесть из тридцати. Глаз читает это как ошибку вёрстки.
Взгляд на строку вперёд
Жадный алгоритм ошибается, потому что не видит следующую строку. Вариант: перед добавлением строки оценить её и следующую, попробовать три предыдущих места разрыва и взять то, где худший промежуток пары меньше.
Первая версия не сдвинула ни одного разрыва на всей книге. Ранний разрыв только расширяет текущую строку, поэтому смотреть надо на следующую: дыра обычно стоит перед длинным словом. После исправления разрывы сместились в 1.1 % случаев, строк шире 0.75 em стало 545 вместо 587, а самый широкий промежуток остался 5.48 em.
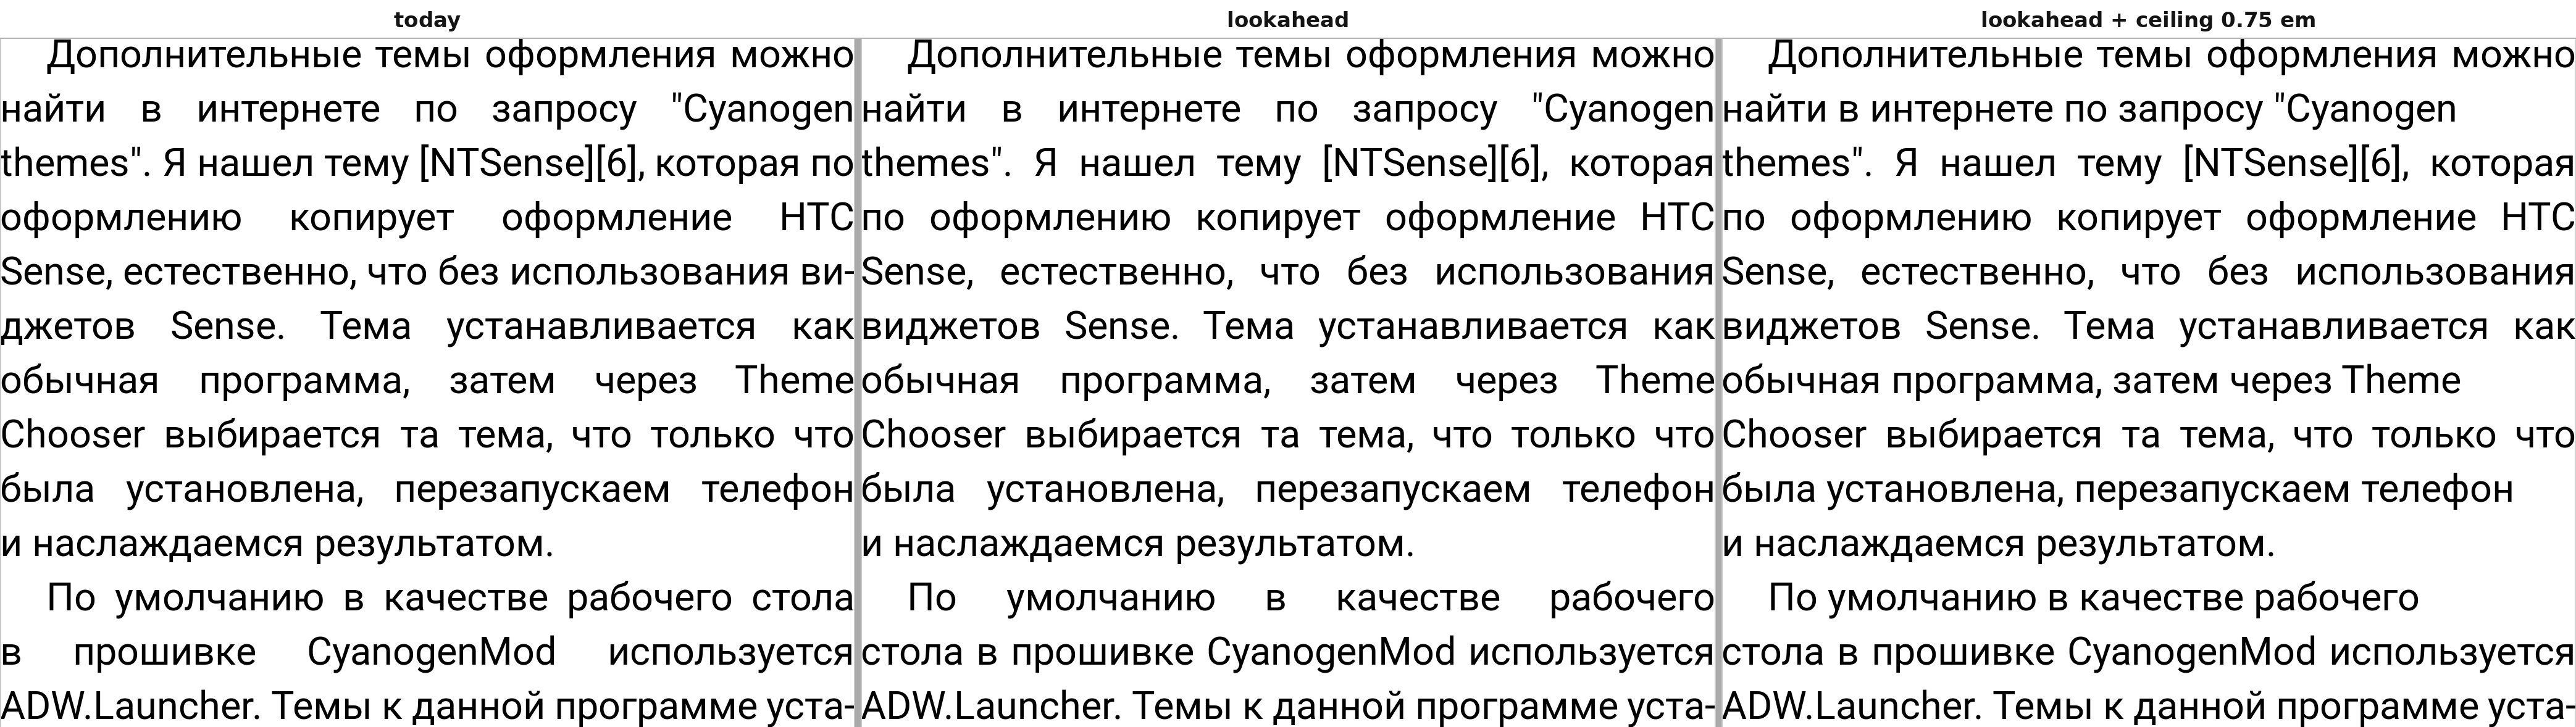
На этой странице хорошо видно, почему так: дыра часто просто переезжает на строку выше. Окна в одну строку мало, остаток ширины накапливается за несколько строк. Цена за это — около 150 строк C++ и +15 % ко времени вёрстки.
Абзац целиком
Настоящий ответ индустрии давно известен. Кнут и Пласс в 1981 году описали разбивку всего абзаца как поиск пути с наименьшей суммарной «плохостью» строк7, этот алгоритм работает в TeX. Paragraph Composer в InDesign тоже оценивает все строки абзаца вместе8. Для самого crengine такую работу уже проделали в надстройке к KOReader9.
Идея такая: выписываем все места, где можно разорвать строку, включая переносы. Для каждой возможной строки считаем штраф за то, насколько её нужно растянуть или сжать. Динамическим программированием находим последовательность разрывов с минимальной суммой. Выбранные разрывы подаём в обычный цикл движка, поэтому слова, позиции и отрисовка остаются его собственными.
| Вариант | p50 | p99 | Самый широкий | Шире 0.5 em | Шире 0.75 em | Вёрстка |
|---|---|---|---|---|---|---|
| сегодня | 0.35 | 1.13 | 5.48 | 20.0 % | 4.4 % | |
| абзац целиком | 0.39 | 0.85 | 2.75 | 23.9 % | 2.2 % | +60 % |
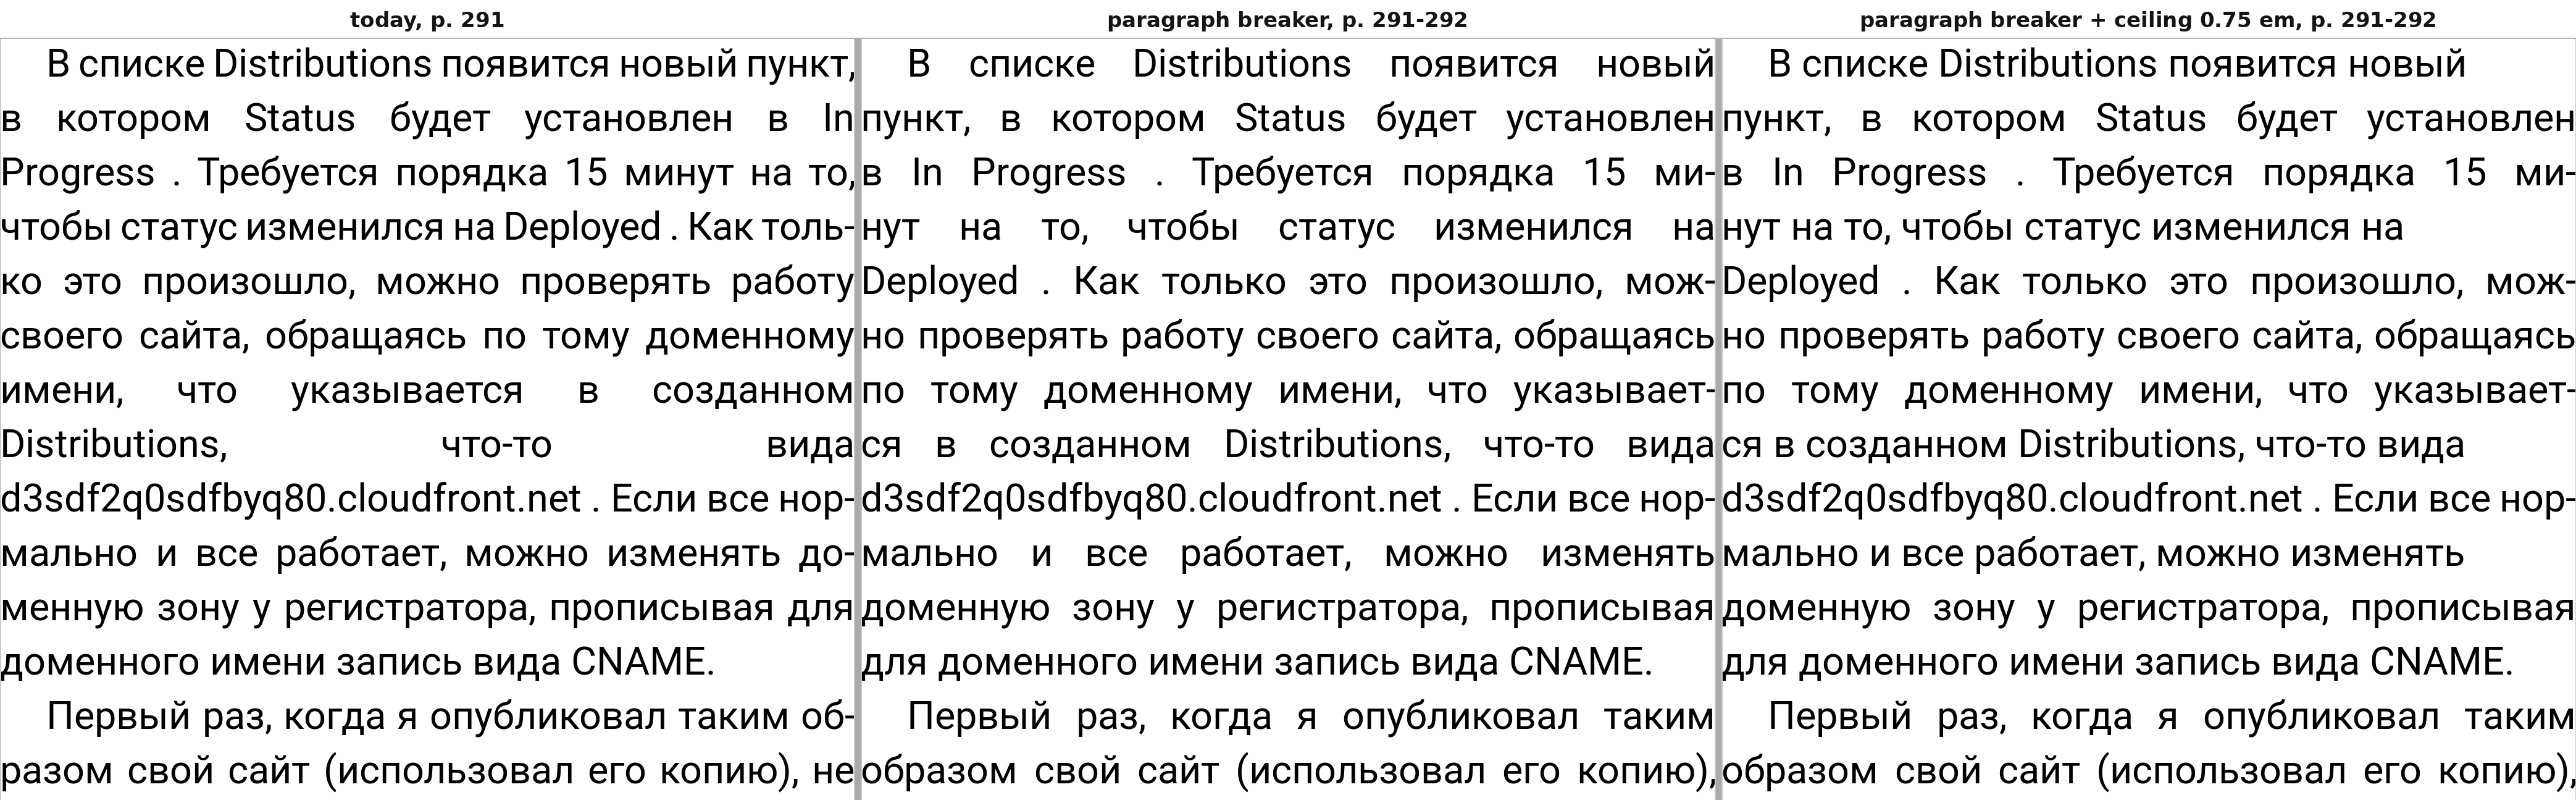
Хвост сократился вдвое, дыра в 5.48 em исчезла. Но вся страница стала немного рыхлее, и на моих глазах одна плохая строка превращалась в несколько средних. Вёрстка книги при этом стала дольше на 60 %. Hermes предложил другую мысль: считать абзац, но менять только те строки, где есть проблема. Её мы и довели до конца.
Что нашлось по дороге
Прежде чем делать новый вариант, я проверил полный алгоритм на странном случае. Если убрать ограничения, он должен быть не хуже жадного: жадный путь для него доступен. А он оказался хуже: 951 строка шире 0.75 em против 517.
Рыхлая страница оказалась следствием одной константы. За два переноса подряд алгоритм добавлял 10000. Число взято из TeX, но там оно складывается с квадратами штрафов и равно одной строке с плохостью 100. У нас штраф линейный, и эта добавка перевешивала всё остальное. При значении 1000 тот же алгоритм становится лучше сегодняшней страницы целиком: на «Под Куполом» Кинга строк шире 0.5 em 10.2 % против 12.5 %. Вывод предыдущего раунда описывал константу, а не метод.
Блог сильно завышал проблему. Мой блог полон названий и путей, а настоящие книги устроены иначе. В семи книгах прозы шире 0.75 em оказалось от 0.3 до 1.2 % строк, а не 5 %. Цель «одна строка из пятидесяти шире 0.5 em» недостижима ни для одного варианта: даже лучший алгоритм даёт 4–11 %.
Латиница в русских книгах не переносилась. Из 295 строк, оставшихся шире 0.75 em после полного алгоритма, у 88 в следующем слове была латиница: Wordpress, Amazon, pages.github.com. Для языка ru движок берёт Russian.pattern, где латинских шаблонов нет, хотя в приложении уже лежит Russian_EnUS.pattern.
Что мы выбрали
Выбрали точечную правку и другой словарь для русских книг. Без настройки и без потолка.
Сначала, как и раньше, считаются жадные строки. Если в абзаце нет промежутка шире 0.75 em, движок работает как обычно. Если такая строка есть, вокруг неё открывается окно: четыре строки до и две после. Только внутри окна алгоритм рассматривает другие разрывы и расставляет переносы, снаружи разрывы остаются жадными, поэтому эти строки не могут измениться.
Два решения в функции штрафа делают алгоритм точечным. Промежуток до 0.5 em ничего не стоит, поэтому обычным строкам незачем меняться. А каждая строка, отличающаяся от жадной, стоит немного, поэтому без причины путь с неё не уходит.
Девять книг в той же настройке. В таблице жадная вёрстка и правка, размеры в em:
| Книга | Шире 0.75 em: было | стало | Самый широкий: было | стало | Шире 0.5 em: было | стало |
|---|---|---|---|---|---|---|
| Кинг, «Под Куполом» | 1.0 % | 0.5 % | 2.05 | 1.46 | 12.5 % | 12.5 % |
| Петросян, «Дом, в котором…» | 1.0 % | 0.5 % | 1.52 | 1.52 | 11.0 % | 10.9 % |
| Макьюэн, «Невыносимая любовь» | 1.2 % | 0.3 % | 1.78 | 1.30 | 11.7 % | 11.6 % |
| Саймак, «Город» | 1.2 % | 0.6 % | 1.28 | 1.28 | 12.6 % | 12.6 % |
| Брэдбери, «Марсианские хроники» | 1.1 % | 0.5 % | 1.25 | 1.01 | 12.7 % | 12.7 % |
| Аллен, GTD | 4.1 % | 1.6 % | 2.15 | 2.15 | 20.0 % | 20.7 % |
| Мой блог | 5.1 % | 2.1 % | 4.94 | 2.43 | 21.2 % | 20.3 % |
| «Война и мир», английский перевод | 0.9 % | 0.3 % | 2.47 | 1.54 | 9.6 % | 9.6 % |
| «Гордость и предубеждение» | 0.3 % | 0.1 % | 1.11 | 1.00 | 7.3 % | 7.3 % |
Хвост в прозе падает примерно вдвое и догоняет полный алгоритм, а основная масса строк почти не меняется. На «Под Куполом» правка затронула 534 строки примерно из 47 000. Время вёрстки выросло на 13–18 % вместо 68–74 % у полного алгоритма. Текст проверен хешем на трёх книгах: все символы на месте, изменилась только разбивка на строки.
Шире всего проверили по матрице из 288 прогонов: четыре книги, четыре шрифта, размеры 16, 18 и 24 dp, две ширины, всего 1.7 млн строк.
| Вариант | Шире 0.5 em | Шире 0.75 em | Шире 1 em | Самый широкий | С переносом |
|---|---|---|---|---|---|
| сегодня | 17.3 % | 3.69 % | 19 257 | 8.36 em | 35.1 % |
| правка | 17.5 % | 2.03 % | 6 543 | 3.54 em | 35.8 % |
Цена тоже есть: переносов на 0.7 пункта больше, а в одной из настроек прозы рост доходил до 1.8. Страниц стало почти столько же, разница не больше 0.33 %.
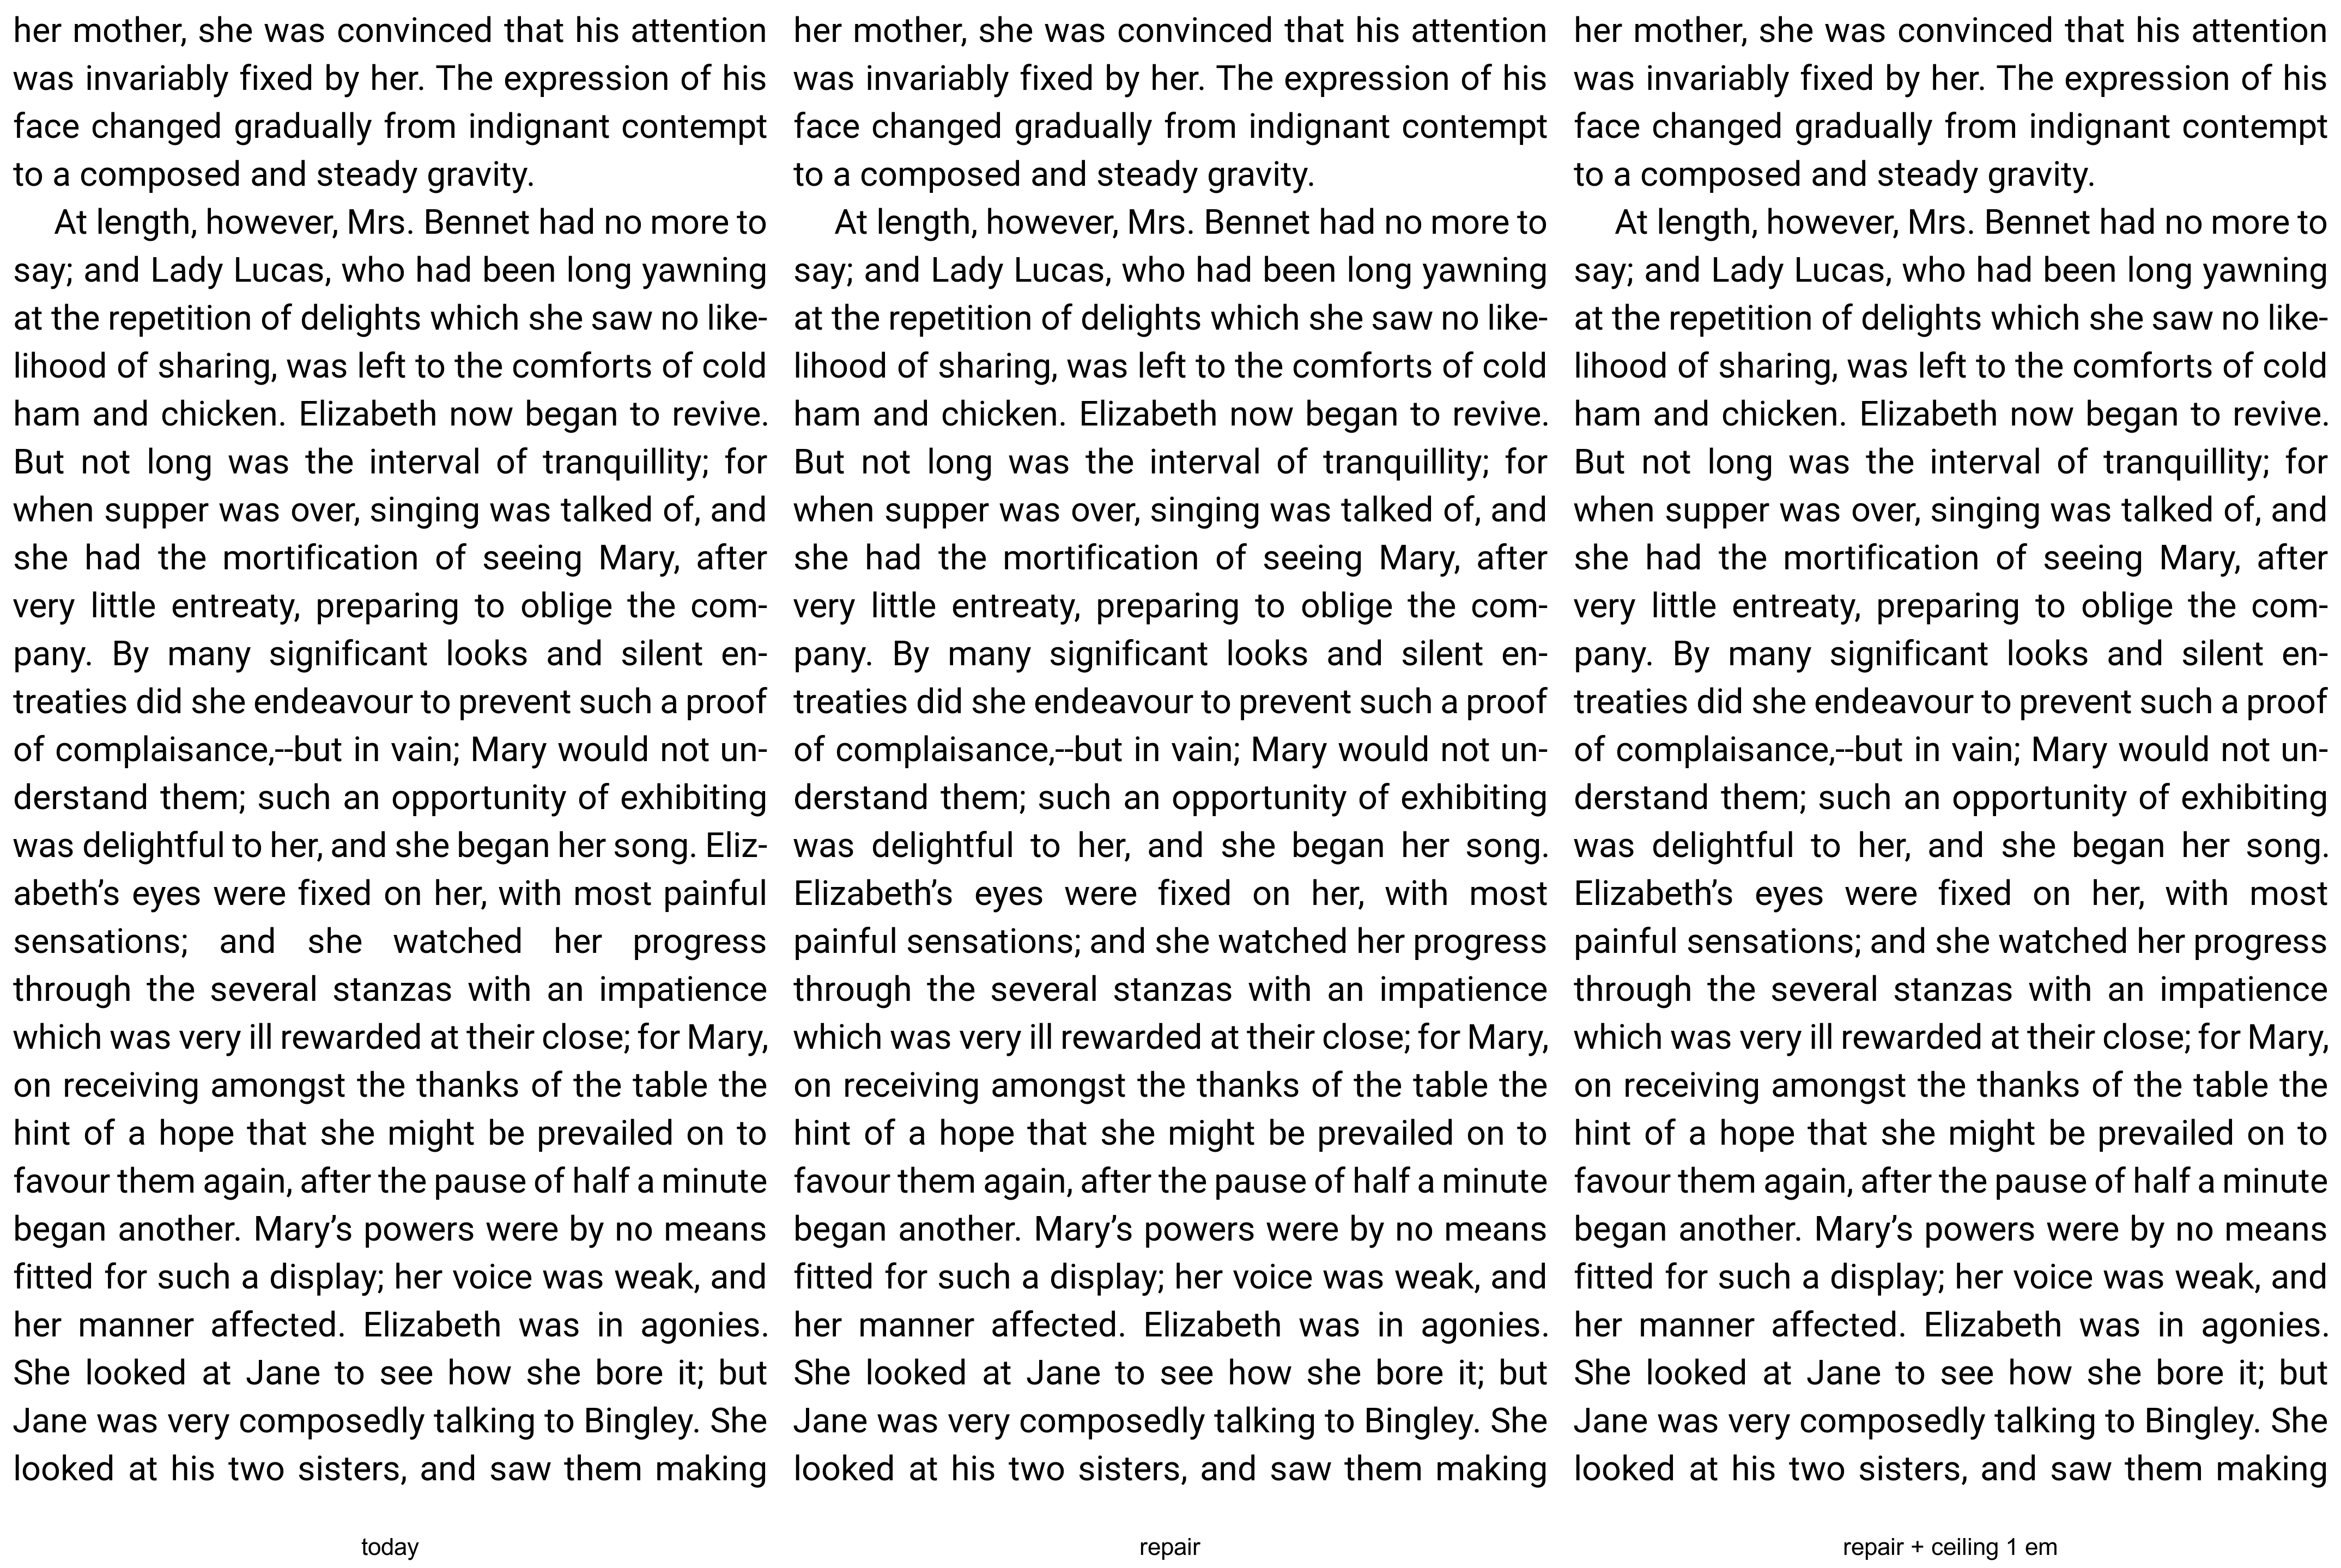
Обычная страница «Гордости и предубеждения»: слева как было, в середине после правки. Изменились три строки, а один перенос вообще исчез. Правая панель с потолком 1 em ничем не отличается, потому что на таких страницах ему нечего делать:
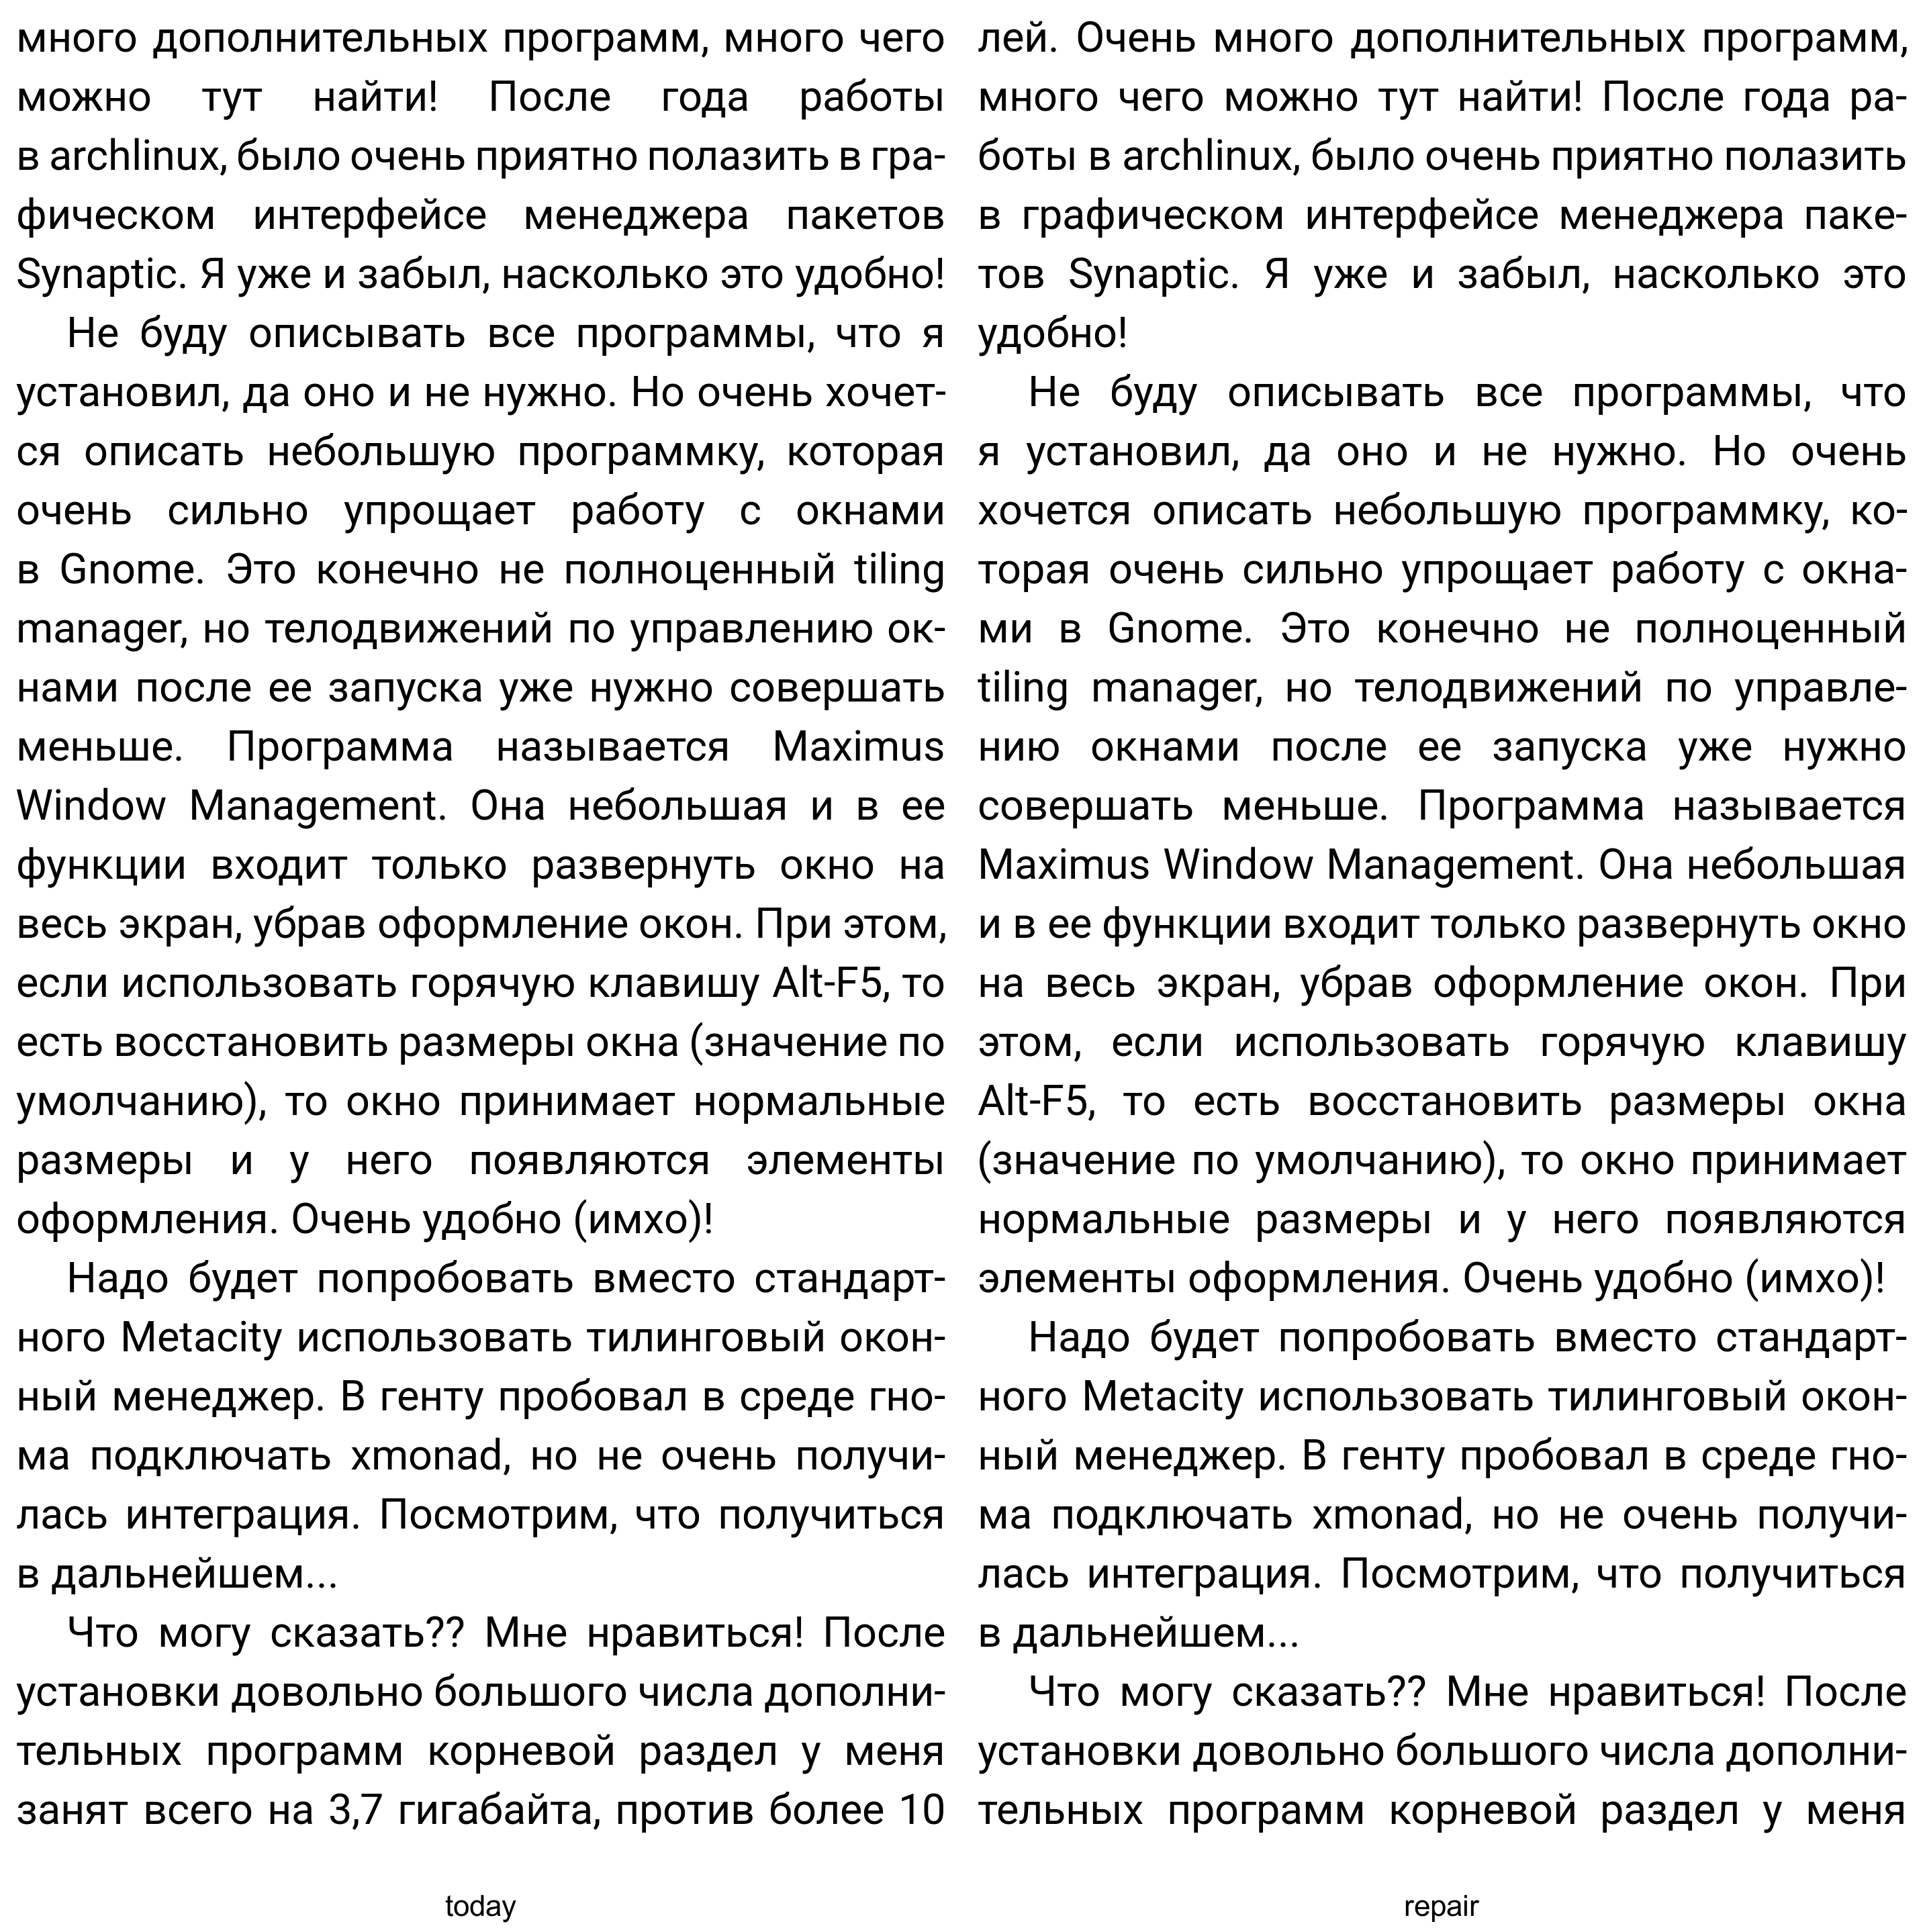
Самый тяжёлый случай, который нашёлся, — страница блога. Дыры ушли, но оба абзаца переработаны, переносов больше, и первый стал на строку длиннее:
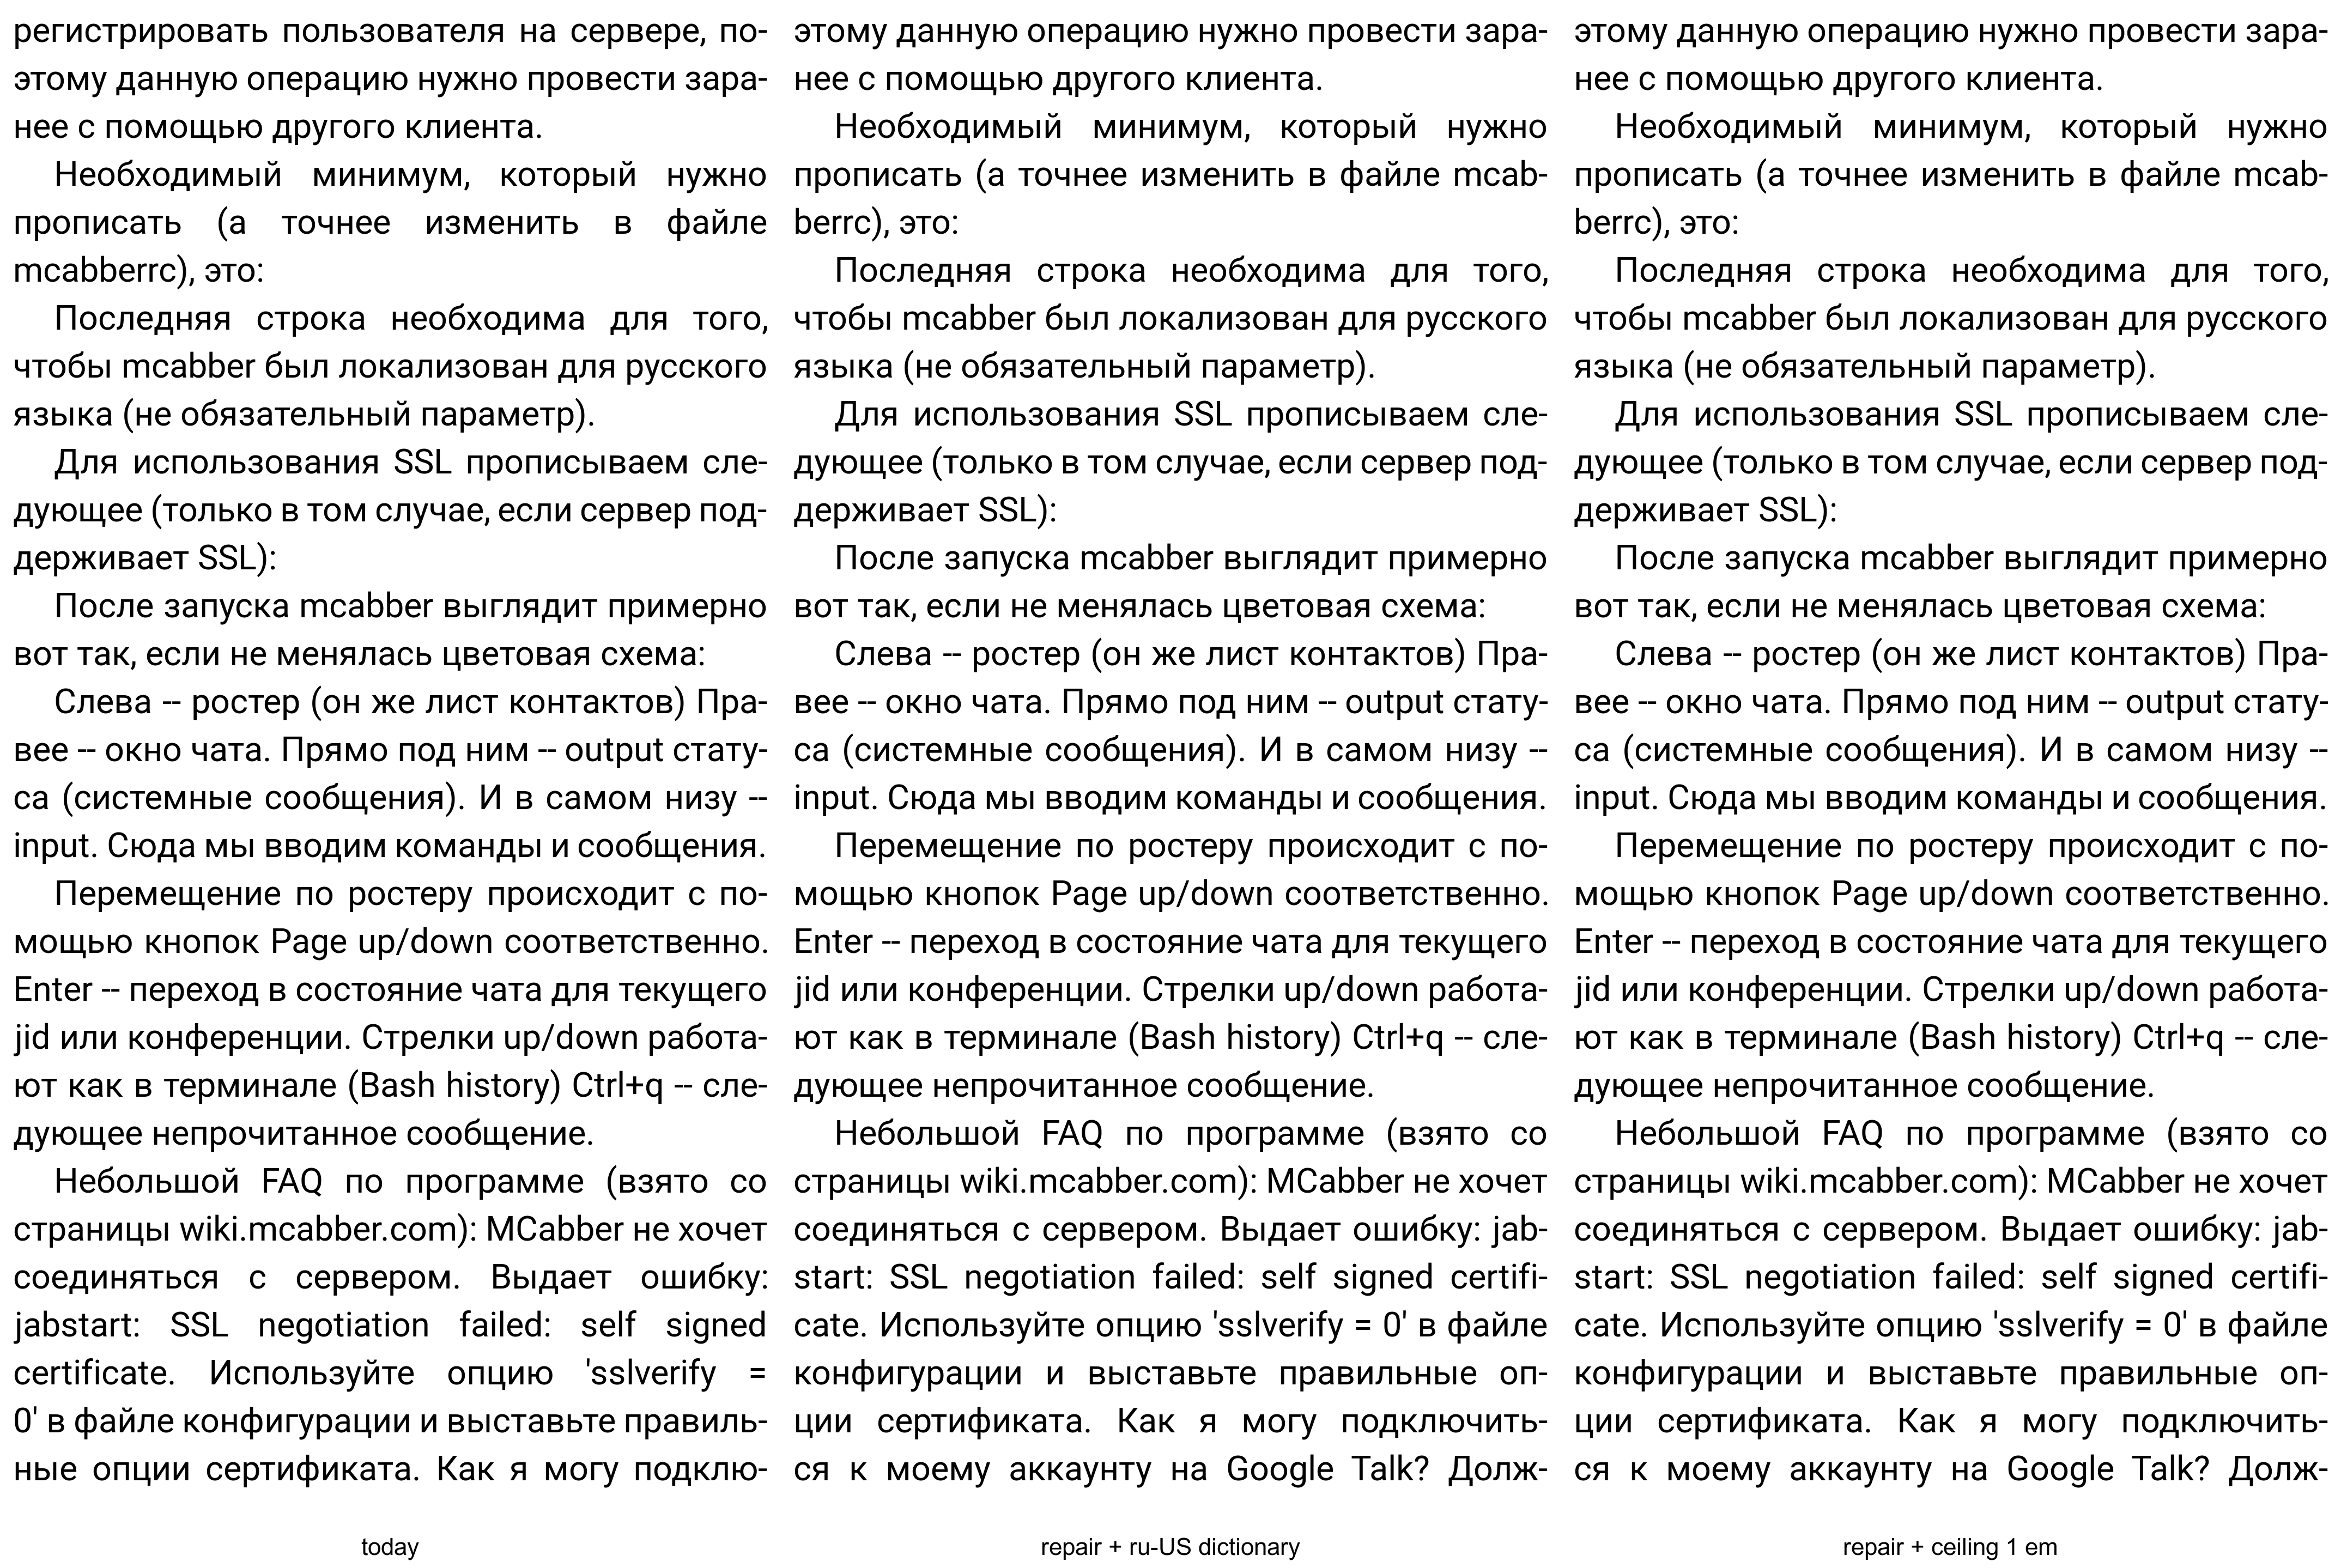
Словарь работает так: файле mcabberrc и ошибку: jabstart теряют дыры, а имена разрываются переносом. Для технических текстов это нормальный обмен, а в художественной прозе словарь почти ничего не меняет. Панели здесь начинаются с разного места, потому что текст немного сдвинулся:
Потолок мы оставили за бортом. В прозе он сработал бы примерно на одной строке из 550, а строка без правого края мне не понравилась сразу. Остаются редкие строки вроде первой строки абзаца из длинных слов или строки перед адресом: двигать там нечего.
Как это сделано
Движок лежит сабмодулем и не форкнут. Приложение несёт к нему патчи: при сборке CMake копирует нужные файлы движка в каталог сборки, накладывает на них патчи и компилирует копии. Вторым таким патчем стала правка, она меняет только форматирование абзаца в lvtextfm.cpp. Документ при этом не трогается, поэтому закладки, выделения и места чтения, которые ходят на сервер, указывают на тот же текст.
Словарь выбирает небольшая функция в JNI-слое при открытии книги. Рядом появился тест, который на настоящем экране эмулятора мерит пустые колонки внутри строки. Без патча он падает: 65 пикселей против предела в 47. Заодно пришлось заново принять контрольные страницы, с которыми сверяется вёрстка.
Измерительный стенд остался в репозитории: патч с записью в CSV накладывается поверх патчей приложения и может отключить правку, так что сравнение с жадной вёрсткой всегда воспроизводится. Весь разбор с цифрами лежит в docs/spikes/word-gaps-preview.md10.
Релиз собирается только в GitHub Actions: тег v0.1.0-rc5, подписанные APK для трёх ABI, заметки из коммитов. Перед тегом прошли сборка, линтер и unit-тесты, а на эмуляторе тесты движка, экранов и синхронизации с bookOrbit.
Так выглядит контрольная страница из тестов приложения, это PT Serif на узкой странице, самом неудобном случае. Строка путешественники переговаривались больше не разорвана пустотой, а цена видна сразу: переносов стало больше.
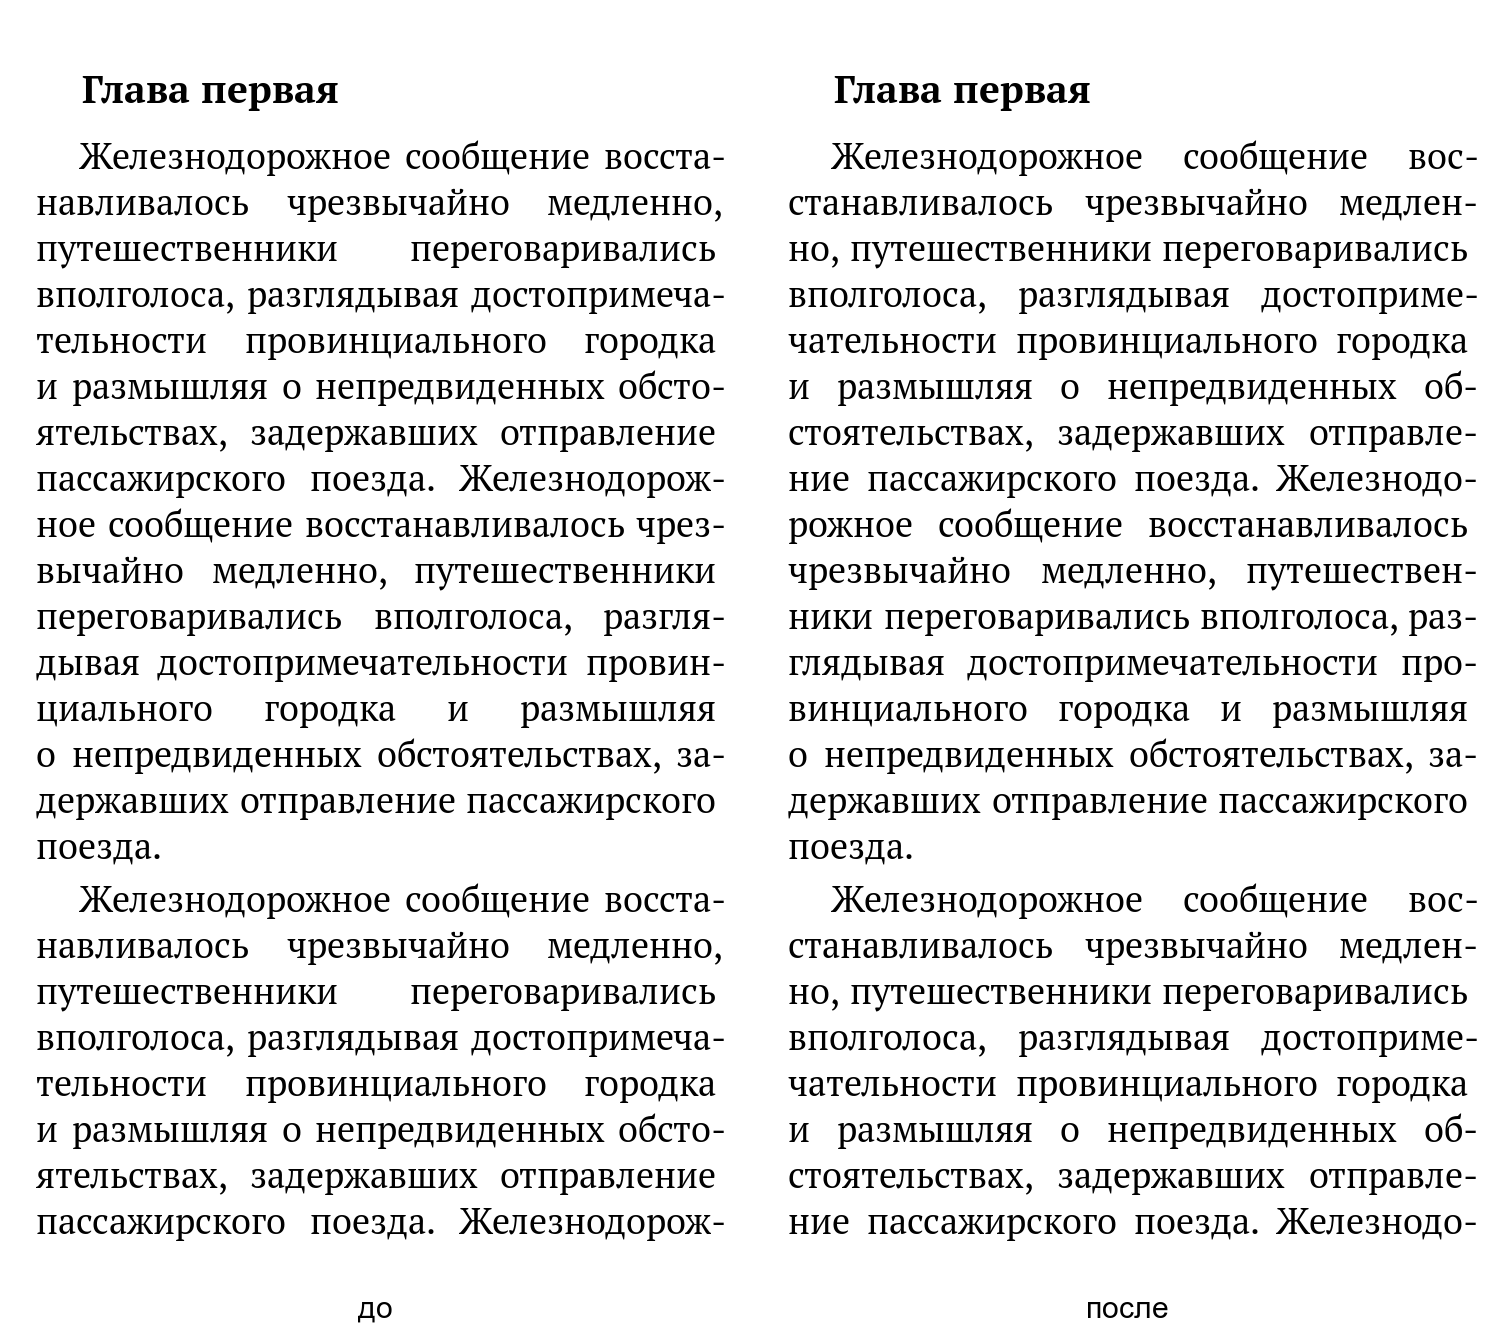
Сборку rc5 я проверил на своём телефоне, и она мне понравилась. Время первого открытия на телефоне мы не замеряли, цифры выше сняты на компьютере.
Perigee пока называется рабочим именем и в магазинах его нет, сборки лежат в релизах на GitHub. Лицензия GPL-3.0.
juev/perigee, репозиторий проекта. ↩︎
Perigee 0.1.0-rc5, подписанные APK. ↩︎
koreader/crengine, движок вёрстки KOReader. ↩︎
Настройки выравнивания в InDesign, по умолчанию межсловный пробел от 80 до 133 %. ↩︎
Donald Knuth, Michael Plass, Breaking Paragraphs into Lines, 1981; краткое описание алгоритма. ↩︎
Set text composition, описание Paragraph Composer. ↩︎
koreader-knuth-justification, постраничная разбивка для KOReader. ↩︎
word-gaps-preview.md, разбор с таблицами и командами для воспроизведения. ↩︎