
memcue: долговременная память для агента и три её схемы за восемь дней
memcue — долговременная память для Claude Code, Hermes Agent и DeepSeek Harness. Это база коротких фактов в одном файле SQLite, один бинарник и несколько hook’ов. Первый коммит появился 19 октября, сегодня вышла версия 0.21.01. За восемь дней набралось 33 релиза, 418 коммитов и больше полусотни исследований в docs/research. Схема за это время дважды менялась целиком. Начинал я с памяти, которая сама подставляет факты в каждый промпт и сама извлекает их из транскриптов. Пришёл к тому, что агент сам ищет в памяти и сам в неё пишет. Ниже — как это было и почему, с цифрами из замеров.
Оговорка сразу: все замеры сняты на моей базе и моих сессиях, выборки маленькие. Их стоит читать как направление, а не как бенчмарк.
Проблема
Агент не помнит прошлых сессий. Что он узнал за работу — как устроен сервер, какое решение я принял на прошлой неделе, почему не сработал очевидный подход, — живёт в контексте и пропадает при /clear, при сжатии контекста и в новой сессии. Следующая сессия начинает с нуля: снова наступает на те же грабли, а я снова объясняю то же правило.
У Claude Code для этого есть встроенная память2. Модель сама пишет заметки в каталог проекта, файл MEMORY.md служит им оглавлением. В начале каждой сессии загружаются первые 200 строк или 25 КБ оглавления, саму заметку агент открывает, когда она нужна. Память своя у каждого репозитория.
С июня я жил с доработанной версией этой схемы. Заметки лежали в ~/.claude/memory/ под git, по каталогу на репозиторий плюс общий каталог _global. Hook на старте сессии подключал нужный каталог и выводил глобальное оглавление. Схема работала, но проблем становилось больше:
- Оглавление перестало помещаться. Вывод hook’а ограничен 10 000 символов, сверх этого агент получает превью в 2 000. Глобальное оглавление доросло до 13 215 символов и уходило одним куском, поэтому сессии вне
~/.claudeвидели примерно 9 записей из ~110. Пришлось резать его на три части. - Знание заперто в своём репозитории. Что агент узнал о сервере, работая в одном проекте, в другом проекте он не видит. А с одним сервером я работаю из многих репозиториев.
- Имя каталога — плохой ключ. Когда имя клона разошлось с именем remote, hook молча завёл пустой каталог памяти, а 24 заметки остались в старом.
- Оглавление стоит токенов в каждой сессии, нужно оно или нет. В сравнении ниже режим с файлами оказался самым дорогим.
Для Hermes Agent я пробовал провайдер памяти holographic. Он ходил за эмбеддингами на каждом ходе. На 100 реальных промптах он подставил 219 фрагментов: полезных из них 8 (4 %), шума 190 (87 %)3.
Задача сложнее, чем кажется. В обзоре чужих систем памяти, который я собрал по ходу работы, общий вывод такой: большинство из них не обгоняют прогон без памяти вовсе4. В VibeMemBench на реальных задачах в репозиториях 11 пар «модель + система памяти» из 12 не превзошли тот же прогон без памяти.
Отсюда требования к memcue. Память общая для всех репозиториев и машин. В контекст попадает только нужное. Поиск быстрый и не делает внешний вызов на каждом ходе.
Первая версия
Утром 19 октября memcue искал прямо по заметкам. Абзацы заметок лежали в индексе FTS5, а hook на каждый промпт подставлял абзацы, в которых нашлась достаточная доля редких слов промпта. К обеду того же дня я перешёл от заметок к фактам. Факт — одно короткое утверждение, понятное без соседей, с датой и местом, где оно получено. Миграция прогнала 312 заметок через Opus и получила 2 335 фактов за $39.83. Поначалу модель дописывала в факты свои выводы, таких было 16 %. После запрета в промпте их осталось 2.5 %.
Переход оправдался на отложенной выборке из 100 реальных промптов, которую ни одна система не видела при настройке:
| Система | Подставлено | Полезных | Шума |
|---|---|---|---|
| holographic | 219 | 8 (4 %) | 190 (87 %) |
| memcue на абзацах заметок | 53 | 9 (17 %) | 31 (58 %) |
| memcue на фактах | 55 | 18 (33 %) | 21 (38 %) |
Первые две строки сняты на другой сотне промптов того же рода: отложенную выборку используют один раз.
Версия 0.1.0 работала так:
- На старте сессии агент получал заметку: память теперь memcue, писать файлы не нужно.
- На каждый промпт hook подставлял не больше двух фактов, в которых нашлось достаточно редких слов промпта. Большинство промптов не получало ничего, так и задумано. Поиск лексический: SQLite FTS5 со стеммингом Snowball для русского и английского, около 10 мс на промпт.
- При сжатии контекста и в конце сессии новая часть транскрипта уходила в
claude -pс Opus, и модель дописывала факты. Только добавление: с базой ничего не сравнивалось. - База — один файл SQLite. Строки не удаляются и не переписываются, у каждой версии факта своя пара (id, версия). Поэтому две копии базы сливаются простым объединением строк, и memcue ставит для этого merge driver в git. Ищутся факты всех репозиториев, факт своего репозитория выигрывает при равном счёте.
Проверка от начала до конца на 30 вопросах дала 27 правильных ответов без memcue и 30 с ним, ходов на ответ стало 2.2 вместо 3.2. В документе это записано как направление, а не значимый результат.
Как менялась схема
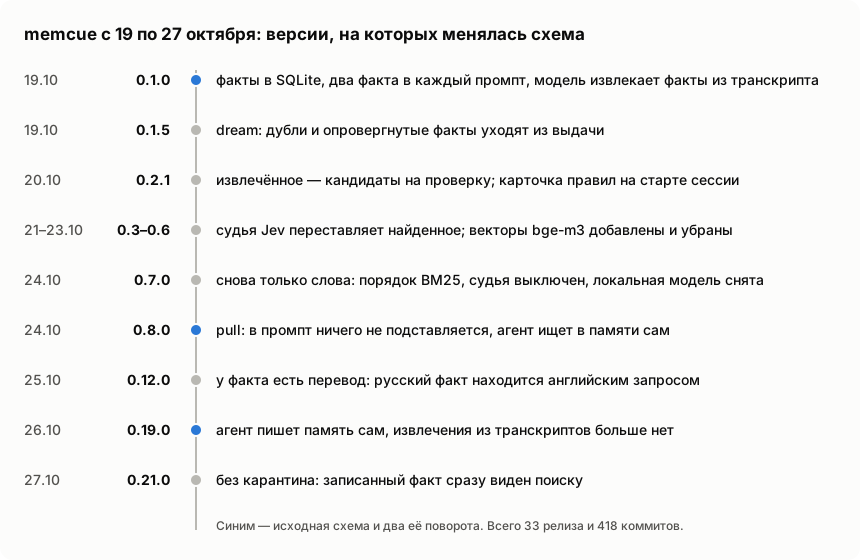
Первый день в работе: шум и дубли
Пилот в первый же день показал то, чего не было в выборках. 14 из 19 промптов, получивших факты, оказались фоновыми уведомлениями о задачах, а один факт пришёл в одну сессию 10 раз. Уведомления hook стал пропускать, а факт выдаётся один раз за сессию. В Hermes сессия шлюза живёт днями, и тот же факт возвращался на каждом ходе. Это исправили передачей идентификатора сессии.
Вторая проблема — дубли. Извлечение не видит базу, поэтому две сессии записывают один и тот же факт, а старый факт остаётся рядом с тем, что его опроверг. В 0.1.5 появился memcue dream: он группирует похожие факты, а модель решает, какие из них дубли и какие устарели. Полный проход по базе из 2 480 фактов стоил $7.58.
Что хранить
Через день стало видно, что около 30 % извлечённых фактов — пересказ репозитория и журнал событий. Агент и так прочтёт это из кода и git log. Новый промпт извлечения оставляет только то, что пригодится следующей сессии и чего нельзя прочесть из репозитория. Я сравнил оба промпта вслепую на 10 других сессиях. Старый дал 102 факта, из них стоило хранить 72–79 (0.71–0.77). Новый дал 66 фактов, хранить стоило 61 (0.92)3.
В 0.2.1 извлечённые факты стали кандидатами: у них есть тип (правило, решение, ловушка, окружение), область действия, источник и цитата из транскрипта. Ещё в 0.2.1 появилась карточка: на старте сессии агент получает глобальные правила и решения текущего репозитория. Карточка нужна для правила, которое агент не догадается искать: подстановка по словам промпта его не найдёт, если слова промпта с ним не совпали.
Судья и векторы
На 120 реальных промптах 35, которым нужна была память, не получили ничего. Сначала я заподозрил поиск кандидатов и собрал размеченный набор. Для каждого промпта в пул попадали первые 10 фактов от трёх поисков: FTS5, векторного по bge-m3 и маленькой модели-классификатора Jev (typesafe/jev-1.14). Получилось 2 538 пар, их вслепую разметила модель. Для 96 промптов из 120 полезный факт нашёлся среди ~21 кандидата. Но на первое место его ставили так: слова — в 44 промптах, векторы — в 215. Значит, кандидаты находятся, а теряется порядок. Нужен судья, который переставит найденное. Jev поверх 10 лексических кандидатов поднял полезный факт на первое место в 70 промптах вместо 43 за $0.009 и 0.7 с на промпт.
В 0.3–0.4 память работала в три модели: основная извлекала факты, Jev переставлял кандидатов, векторы добавляли кандидатов, которых не нашли слова. Векторы прожили недолго. Исследование «одна модель или три» показало, что судья, читающий 20 кандидатов в порядке BM25, находит без векторов столько же полезного, сколько с ними6. Локальный Ollama с bge-m3 держит в памяти 1.3 ГБ. Векторы не переносятся между машинами с разными эмбеддерами и занимали 13.3 из 24.7 МБ базы, которую тащит каждая синхронизация. В 0.5.0 векторы удалены. Цена судьи — время: собственный hook стоит около 45 мс, с эмбеддером и судьёй через внешний сервис промпт ждал 1.0–1.8 с.
Сравнение с файлами
23 октября я сравнил memcue со старой файловой памятью от начала до конца7. Взял 40 реальных промптов и на каждый запускал claude -p --model opus в режиме плана на клоне репозитория, откаченном к моменту промпта. Знания за обеими памятями одинаковые: снимок одной базы на момент промпта, для файлов разложенный обратно по заметкам. Режимов четыре: без памяти, файлы с MEMORY.md, memcue на одних словах и memcue с судьёй. Каждый режим прогонялся дважды, ответы оценивала вслепую отдельная модель по шкале от 0 до 2.
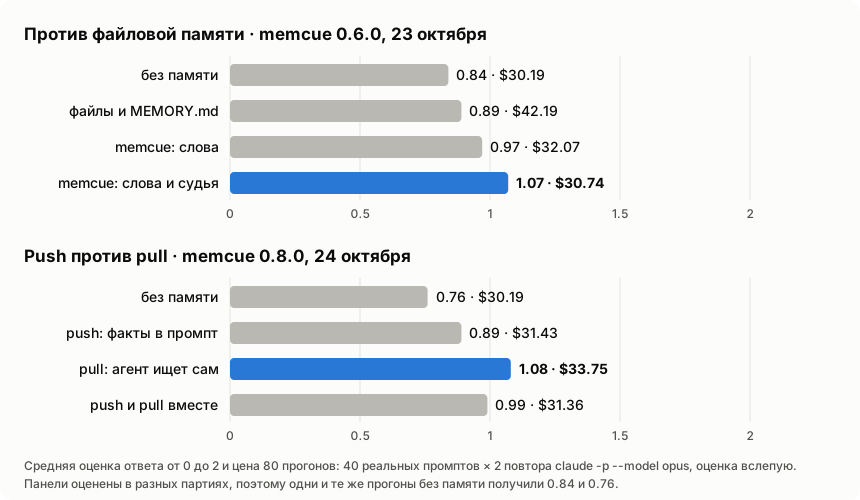
За пределы шума вышла только разница между судьёй и прогоном без памяти: +0.23, 95 % интервал [+0.06, +0.41]. Слова против файлов дали +0.08 [−0.11, +0.28], то есть внутри шума, зато за три четверти цены: $32.07 против $42.19. Файлы дороже всех, потому что оглавление уходит в контекст целиком. Ещё это самый нестабильный режим: у 21 промпта из 40 оценка менялась между повторами.
Назад к словам
Следующим шагом я попробовал обойтись без внешнего судьи. Деревья решений поверх признаков слов и cross-encoder, дообученный на ответах Jev, ставили полезный факт первым в 49–61 промпте против 92–94 у Jev8. От начала до конца деревья набрали 0.95 против 0.96 у одних слов и не окупили 340 КБ, которые добавляли в бинарник. Их убрали. Ещё помогла простая вещь: сортировать кандидатов по BM25, а не по доле совпавших слов. Полезный факт получили 205 промптов против 180, шума стало 30 % против 41 % (p = 0.012).
Судью в 0.7.0 выключили по умолчанию из-за конфигурации. Endpoint Jev, настроенный для уборки базы, включал судью и на каждый промпт. В 0.8.0 слой переранжирования удалили целиком. Направление записано в issue: поиск локальный, без лишних вызовов модели. По той же причине dream перешёл на модель самой сессии: бинарник готовит пакет фактов, модель сессии решает, бинарник применяет ответ. Раньше это был отдельный процесс, который оплачивается отдельно от сессии.
Pull вместо push
Главный поворот случился 24 октября, в 0.8.0. Hook больше ничего не подставляет в промпт. Вместо этого заметка на старте сессии говорит агенту искать в memcue самому перед ответом на вопрос, который может зависеть от прошлых сессий: несколько раз, синонимами, с именем системы, на обоих языках9.
Замер повторял сравнение с файлами: те же 40 промптов, по два прогона, оценка вслепую, 240 прогонов за $96.54. Без памяти ответы набрали 0.76, push (факты в промпт) — 0.89, pull (агент ищет сам) — 1.08, оба режима сразу — 0.99. Pull против push дал +0.19, 95 % интервал [+0.03, +0.37]. Это первое изменение в серии замеров, выигрыш которого вышел за пределы шума. Стоит pull столько же: $33.75 против $31.43 за 80 прогонов. Агент искал в 62 прогонах из 80, в типичном прогоне два запроса.
Почему так, не проверено. Гипотеза: свой запрос агент пишет с именем системы, синонимами и на втором языке, а слова промпта такого запроса не дают. Pull без фактов других проектов ничего не выиграл, −0.09 [−0.23, +0.05].
Pull без судьи получил 1.08, в той же шкале судья в прошлом замере получил 1.07. Сравнивать оценки разных партий напрямую нельзя (пустой режим в них получил 0.84 и 0.76), но лишняя модель на каждом ходе больше не нужна.
После перехода поиск подстроили под агента. По живым наблюдениям в Hermes каждый полезный факт оказывался в первой пятёрке, поэтому поиск отдаёт до пяти фактов. Потом добавили порог: факт с BM25 ниже 0.6 от лучшего отбрасывается. Иначе на запрос, на который отвечает один факт, приходили ещё четыре случайных. С порогом случайных фактов стало 12 вместо 19, а на поиск в среднем приходится 4.2 факта вместо 510. Ещё агент получил флаги -in, -kind, -since: где искать, какой тип факта, с какой даты.
Два языка
Факты в базе в основном русские, а агент пишет запросы примерно наполовину по-английски: в транскриптах нашлось 20 английских запросов, 14 русских и 7 смешанных. Русский факт по английскому вопросу попадал в первую пятёрку 22 раза из 30, остальные сочетания языков — 29–30 из 3011. В 0.12.0 к каждому факту добавили перевод, который видит только индекс. На копии всей базы русский факт по английскому вопросу стал попадать в пятёрку 30 раз из 30, первым — 23 раза вместо 12. Перевод 2 855 фактов стоил $19.92 и 20 минут, база выросла с 17 до 29 МБ.
Агент пишет сам
Второй поворот — 0.19.0, 26 октября12. Извлечение из транскриптов удалено, память пишет сам агент командой memcue add, как это делает встроенная память Claude Code. Поводом стали цифры с живой базы:
- агент почти ничего не записывал сам — 5 вызовов
addза полтора дня, в основном тесты: заметка на старте сессии говорила ему, что писать не нужно; - 83 % живых фактов (3 015 из 3 618) произошли из заметок, которые модель писала сама с июня по октябрь, а 16 из 31 глобального правила на карточке взялись оттуда же;
- до memcue модель писала заметки, которые по оценке в issue дают 20–30 фактов в день, — тот же порядок, что у извлечения (57 в день);
- извлечению нужен отдельный вызов модели на сессию и ещё один на проверку: проверка отклонила 206 из 527 извлечённых фактов, а полтора дня стоили около 657 тысяч входных и 178 тысяч выходных токенов. Это противоречило решению от 24 октября не звать никакой модели, кроме той, которой отдаются факты.
Переключение прошло без теневого периода: извлечение выключено, а не запущено рядом для сравнения. В 0.21.0 убрали и карантин: факт, который модель решила запомнить, сразу доступен поиску.
Что получилось
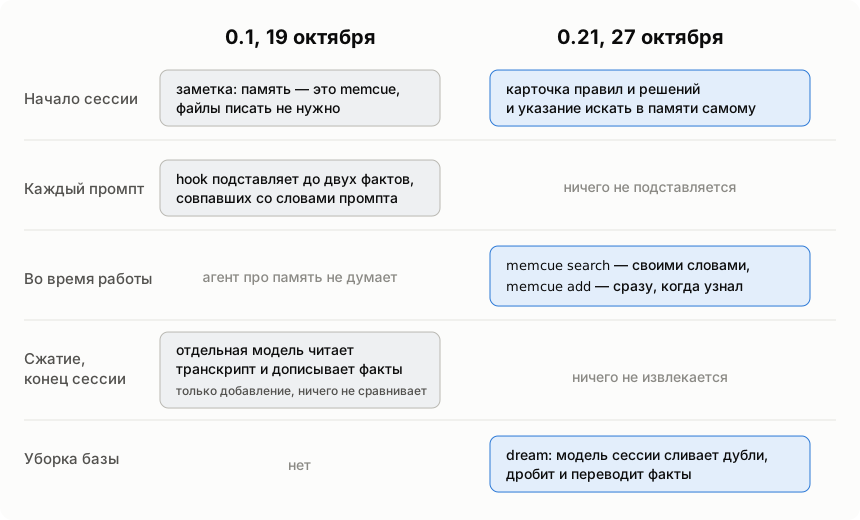
Сейчас memcue работает так:
- На старте сессии, после сжатия контекста и после
/clearагент получает указание искать в памяти и карточку: глобальные правила и решения текущего репозитория. - Когда агенту нужно что-то из прошлых сессий, он сам запускает
memcue searchсвоими словами. Поиск отдаёт до пяти фактов, около 10 мс, без сети и без вызова модели. Внутри репозитория он ищет факты этого репозитория, этой машины и глобальные, флаг-in allрасширяет поиск на всю базу. - Когда агент узнал что-то, что понадобится позже (правило или поправку от меня, решение, которого не видно в коде, ловушку, хост или сервис вне репозитория), он сразу записывает это через
memcue add. dreamвремя от времени сливает дубли, дробит составные факты, переводит их и убирает устаревшие. Работает модель сессии.- База — один файл SQLite, который синхронизируется между машинами через git с merge driver. На моём Mac в ней 3 636 активных фактов.
Что измерено против первой версии и против файлов:
| Сравнение | Результат | Шум? |
|---|---|---|
| факты против абзацев заметок, 100 промптов | полезных 33 % против 17 %, шума 38 % против 58 % | разметка, без интервала |
| слова против файлов, 40 промптов × 2 | 0.97 против 0.89, $32.07 против $42.19 | внутри шума |
| pull против push, 40 промптов × 2 | 1.08 против 0.89, $33.75 против $31.43 | вне шума |
Не измерено главное изменение последних дней — запись самим агентом. Режим «агент пишет сам» не сравнивали с извлечением, issue про сквозной замер записи и поиска закрыт без выполнения. Аргументы за запись агентом — косвенные: доля фактов из заметок модели и стоимость извлечения.
Что не сработало
Отрицательных результатов в репозитории не меньше, чем положительных, и сэкономили они не меньше:
- Векторы. Добавили кандидатов, но 20 кандидатов по BM25 давали то же. Векторы стоили гигабайт памяти и половину объёма синхронизации.
- Внешний судья на каждом ходе. Работал лучше всех, но добавлял секунду ожидания и внешний вызов. Pull получил то же без него.
- Локальные ранжировщики. Деревья решений и cross-encoder не догнали ни судью, ни простые слова.
- Жёсткий фильтр по проекту. Срезал 37 % шума, но терял нужный факт примерно в 20 промптах. Мягкий порог для чужих фактов срезал 19 % и терял в 313.
- DuckDB вместо SQLite. Инкрементальный полнотекстовый индекс DuckDB не обновляется при изменении индексируемой колонки, второй процесс не открывает файл даже на чтение, а драйвер требует CGO: hello-world с ним весит 76 МБ, весь memcue — 20.9 МБ14.
- Извлечение по шаблонам, как у holographic («я предпочитаю…», «мы решили…»). На 55 моих сообщениях из 10 сессий шаблоны не нашли ничего, а разметчики нашли 96 долговечных фактов.
Что дальше
memcue молодой и меняется каждый день: только за 27 октября вышла 0.21.0, а следующий релиз уже готовится. Открытые вопросы:
- как часто агент сам ищет в памяти в обычной работе, а не на вопросах замера. Для Hermes ответа пока нет, жду хотя бы десяти обычных сессий;
- как записывает агент: какие факты он сохраняет, какие пропускает и не засоряет ли базу. Это прямой замер, которого после 0.19.0 не было;
- переход установок на новую схему базы.
Попробовать можно так. Установить плагин в Claude Code:
/plugin install memcue --marketplace juev/memcue
Выключить встроенную память, чтобы агент не вёл вторую память в файлах: "autoMemoryEnabled": false в ~/.claude/settings.json. Перенести то, что уже накопилось: memcue migrate -all. Каждая заметка один раз проходит через модель. Для Hermes Agent и DeepSeek Harness в репозитории есть свои плагины и инструкции. Если что-то работает не так, заводите issue в juev/memcue
.
juev/memcue , README и releases . ↩︎
How Claude remembers your project , раздел про auto memory: первые 200 строк
MEMORY.mdили 25 КБ загружаются в начале каждой сессии. ↩︎docs/evaluation.md , раздел «Holdout: 100 real prompts». Разметка вслепую отдельными агентами. ↩︎ ↩︎
Обзор других систем памяти : Claude Code, Codex, Cursor, mem0, Graphiti, Letta и академические бенчмарки. Измерений в нём нет, только чтение источников. ↩︎
Размеченный набор : 233 факта Hermes, 120 промптов, разметка вслепую. ↩︎
memcue против файловой памяти : метод, все прогоны и повторная оценка. ↩︎
Порог для поиска , issue #407. ↩︎
Issue #494 : агент пишет память сам, извлечения из транскриптов нет. ↩︎
Фильтр по месту факта , 432 промпта Claude Code. ↩︎